
Agentic AI / Generative AI
Keep Distributed Training Running with Automated Workload Recovery
2026 年 11 月 02 日
随着分布式 AI 训练规模不断扩大,硬件与软件依赖项中的故障越来越频繁地打断训练进度,快速可靠的恢复机制变得至关重要。一个停滞的训练进程(rank)可能触发 NVIDIA 集合通信库(NCCL)超时,某个 GPU 节点可能停止响应调度器,或者个别滞后节点(straggler)会拖慢整个任务。单次中断或许尚可应对,但累积影响与恢复开销决定了系统能将多少物理时间转化为有效的训练进展或实际产出量(goodput)。
当需要全天候、大规模地为集群内的每一个训练任务提供手动恢复时,这种模式将难以为继。每次中断都需要进行日志分析、故障隔离以及从保存的检查点重启,而在此期间受影响的 GPU 只能闲置。随着训练任务数量与规模的增加,重叠故障会加重工程负担并造成大量 GPU 工时浪费。若缺乏持续覆盖,这些损失将不断累积,进而推高整体计算成本并延长训练周期。
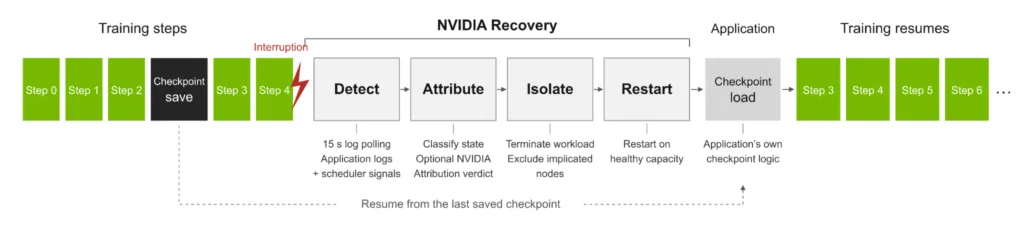
NVIDIA Recovery 隶属于 NVIDIA DSX OS。该模块化软件组合与 NVIDIA DSX AI Factory Platform 共同构成完整生态。作为一项开源的工作负载级服务,NVIDIA Recovery 能够全天候自动处理集群内所有训练任务的恢复工作。它通过应用日志、GPU 指标与调度器信号检测中断,利用故障归因定位受影响资源,并在健康容量上协调资源隔离与检查点重启。通过在各类工作负载中自动化这一恢复闭环,该系统可并发处理中断事件,减少人工干预,并有助于维持训练的有效产出量。本文将详细介绍该恢复闭环的工作原理、NVIDIA Recovery 与 Slurm 的集成方式,以及如何在您的集群中部署它。
工作负载恢复是独立的 AI 工厂核心议题
我们在之前的 NVIDIA DGX Cloud 韧性文章、GTC 演讲以及 NVIDIA Mission Control 2.5 文章中,曾介绍过一种分层架构来保障训练效率。NVIDIA Recovery 在此基础上进一步演进,将基础设施修复与上层工作负载恢复紧密衔接。
故障排查自动化(Break-fix automation)负责识别异常节点、将其下线,并将硬件送往维修通道。诸如 NVRx 之类的框架级库可在单个训练任务内部提供恢复、挂起检测与滞后节点缓解功能,但每位用户仍需自行配置和管理这些能力。而 Slurm 等集群工作负载管理器则专注于资源分配、任务排队与容器执行。
工作负载恢复是一个独立的协调问题:恢复有效训练需要将故障归因于具体原因,决定受影响的作业是否重启以及在哪里重启,并在共享基础设施的工作负载间保持一致的行动。解决这一问题需要一个集群级控制回路,将基础设施修复、框架级恢复与集群工作负载管理相结合,并通过运行指标来跟踪恢复延迟、恢复成功率以及恢复有效训练所需的时间。
多层级 NVIDIA 健康与弹性架构
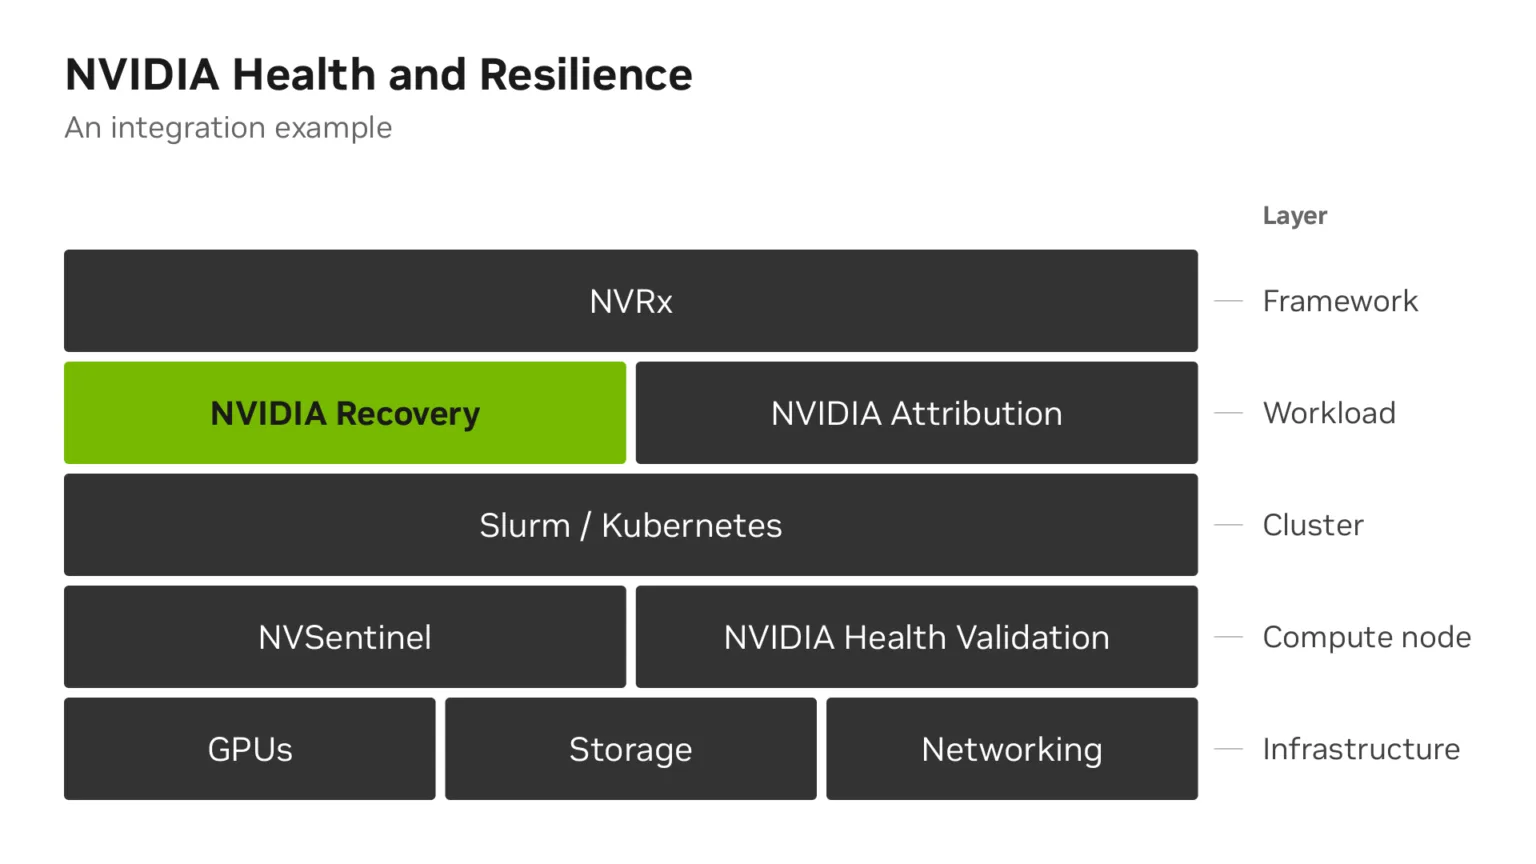
如图 1 所示,NVIDIA Recovery 在 DSX OS Stack 中提供了专用的工作负载恢复层。节点健康监控与隔离依赖于集群的编排与工作负载管理栈。Kubernetes 部署通常使用 NVSentinel 来监控 GPU 健康指标与 XID 事件,并自动将故障节点隔离与排空。许多 Slurm 站点通过自定义的前置与后置脚本来检查节点健康状态。来自 Slinky 项目的 slurm-operator 在 Kubernetes 上运行 Slurm 时,能够原生支持并注入这些脚本。在单个训练作业内部,NVRx 提供了用于作业内恢复与停滞检测的库。NVIDIA Recovery 在集群层面协调跨工作负载的恢复流程,并与上述能力集成,以统一管理作业重启、任务放置与节点排除。
图 1. NVIDIA Recovery 在健康与弹性集成中的角色
这些层级相互独立且无强依赖关系,允许您按需采用各模块化组件,或接入自有平台组件进行集成。例如,若您的集群已依赖 NVSentinel 或 NVIDIA Health Validation,则只需对现有健康工作流进行极少甚至无需修改,即可无缝集成 NVIDIA Recovery。
对于已运行 NVRx 的环境,NVIDIA Recovery 通过管理工作负载间的生命周期与节点排除机制,填补了作业内重启无法覆盖的空白。当与 NVIDIA Attribution 配合使用时,它能接收丰富的跨层诊断结论,从而完善持久化的审计追踪记录。
空白带来的成本代价
在集群规模下,偶发的单卡故障会不断累积放大。
原文较长(约 13,488 字),完整内容请浏览更多。