NVIDIA 共设计五大策略提升 AI 工厂内存价值
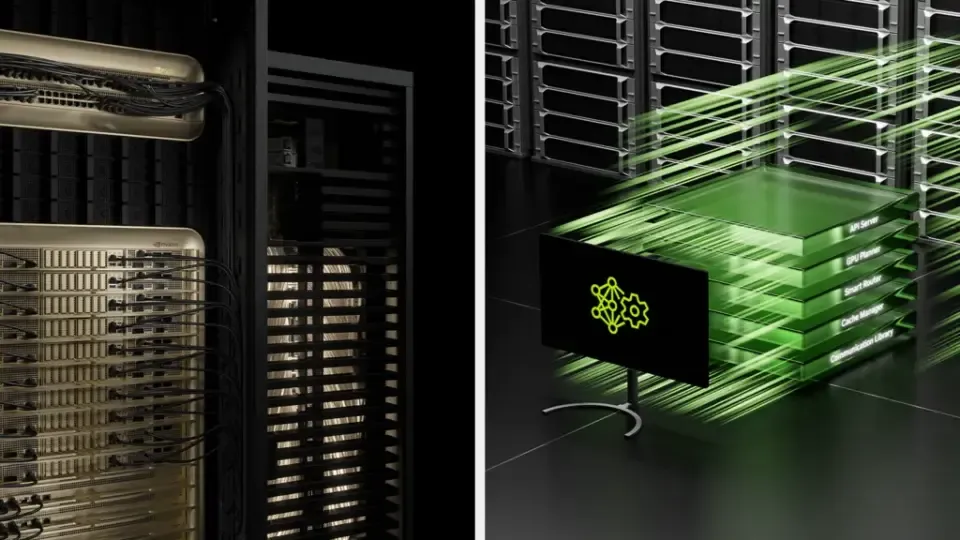
文章指出在 AI 工厂中,高带宽内存是核心资源。通过 GPU 架构、互联、软件等共设计,NVIDIA 实现了从 GB300 到 Vera Rubin 的 30 倍吞吐量增长。这主要得益于 NVFP4 等格式优化及上下文复用,显著提升了每字节的有用工作产出。
文章指出在 AI 工厂中,高带宽内存是核心资源。通过 GPU 架构、互联、软件等共设计,NVIDIA 实现了从 GB300 到 Vera Rubin 的 30 倍吞吐量增长。这主要得益于 NVFP4 等格式优化及上下文复用,显著提升了每字节的有用工作产出。
NVIDIA DSX OS 提供工具链以配置、认证和运维 Kubernetes GPU 集群。通过 AICR 建立可复现基线,NVCRE 验证集群就绪状态并识别故障节点,NVSentinel 监控健康并支持故障修复,旨在解决性能盲区,提升 AI 工厂的集群效率与韧性。
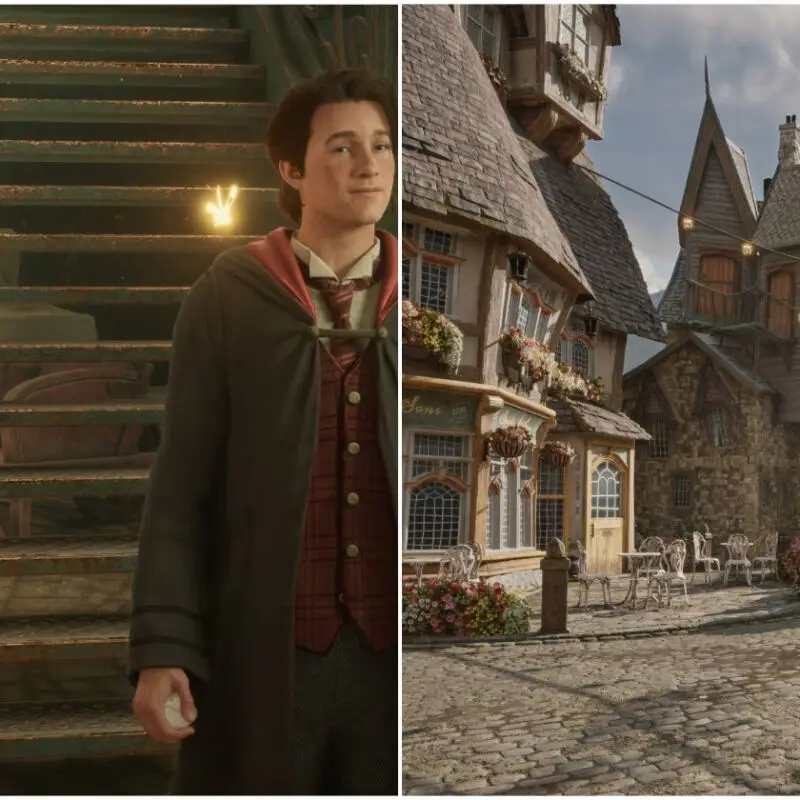
NVIDIA 的下一代 DLSS 5 技术于 11 月正式登陆《霍格沃茨之遗》等游戏。该版本引入 3D 引导神经渲染,旨在提升光影与材质质量的同时保留角色特征。官方演示效果较泄露版更为微妙,目前仅支持 RTX 50 系列显卡。
NVIDIA 在 v621.01 游戏驱动中修复了导致 Meta Quest Link 出现画面冻结和伪影的长期问题。此前用户需降级驱动或切换至 Steam Link 等替代方案,此次更新使 PCVR 连接恢复正常,解决了困扰社区长达十个月的兼容性故障。
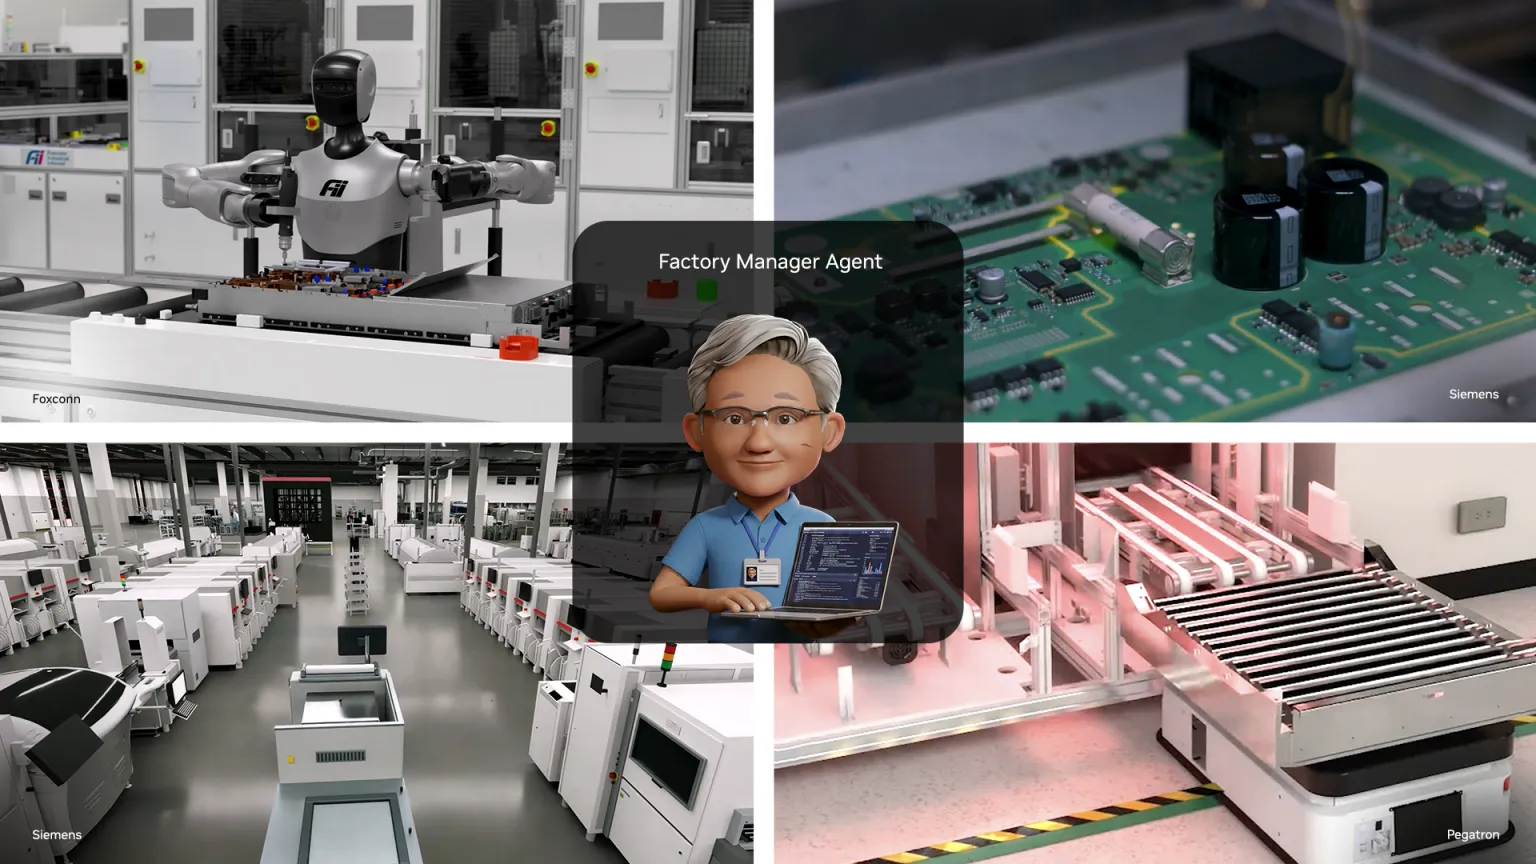
NVIDIA Factory Operations Blueprint (FOX) 提供工厂管理代理参考架构,连接现有数据与工具。在西门子工厂中,AI 代理通过仿真优化排产并生成虚拟原型,实现最高 20% 的成本节约,提升生产效率与良率。
NVIDIA DSX AI Factory Platform 推出 Workload Map,为 Kubernetes 分布式 AI 工作负载提供通用结构描述。该方案消除针对不同框架的专用解析代码,使调度器、控制器和平台能直接复用定义进行巡检、同步调度及状态监控,显著提升多租户环境下的开发效率与运维一致性。
NVIDIA AI Cluster Runtime (AICR) 通过可复用配置配方,简化了 Kubernetes 对 NVIDIA Vera Rubin GPU 的驱动、内核及调度器优化。该方案确保集群在部署首日即可高效运行,解决新硬件适配复杂且易出错的问题,提升多租户 AI 工厂的运维效率。
NVIDIA Recovery 是 DSX OS 中的开源服务,通过自动检测故障、隔离资源并从检查点重启,解决大规模分布式 AI 训练中因硬件或软件问题导致的任务中断。该方案减少人工干预,维持集群算力利用率并提升有效训练进度。
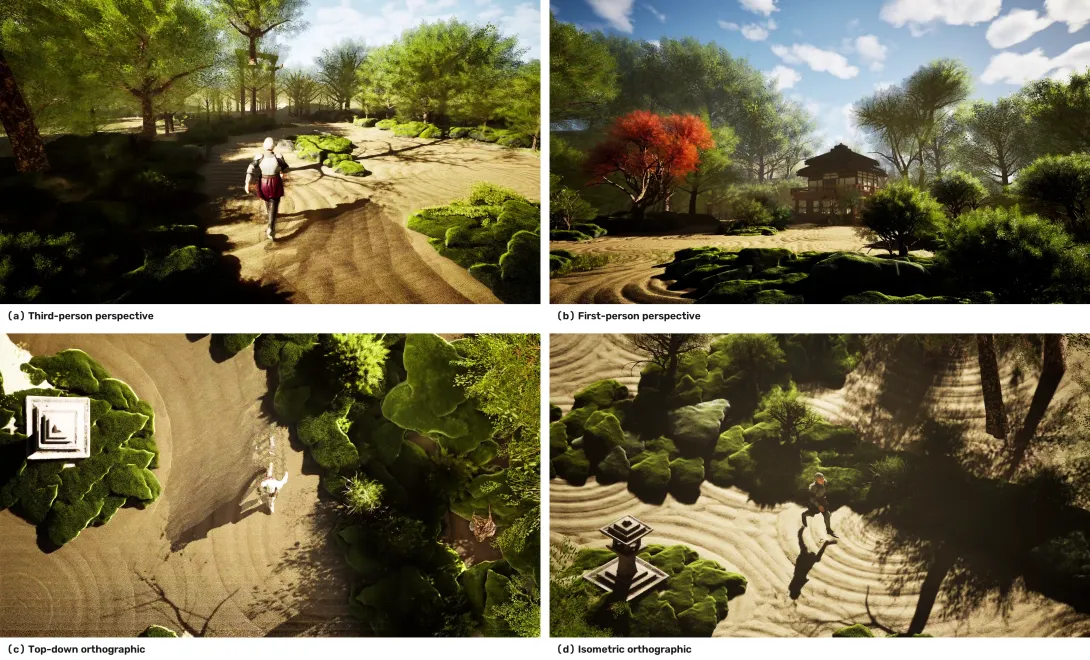
NVIDIA Research 推出 Isekai3D SDG,这是一个基于虚幻引擎插件的合成数据生成平台。它通过两阶段工作流录制并回放世界模拟,自动捕获 RGB、深度等互补视角及元数据。该平台支持自动化生成多样化的 3D 游戏视觉数据,无需安装编辑器即可使用,旨在服务于世界模型、计算机视觉及神经图形学研究。
NVIDIA AI Cluster Runtime (AICR) 将 Dynamo 及其基础设施打包为经过验证的配方,解决 GPU 驱动、资源分配和调度等依赖问题。该平台提供可重复的部署路径,确保模型配置到推理端点的稳定运行,帮助团队专注于应用测试与性能优化。
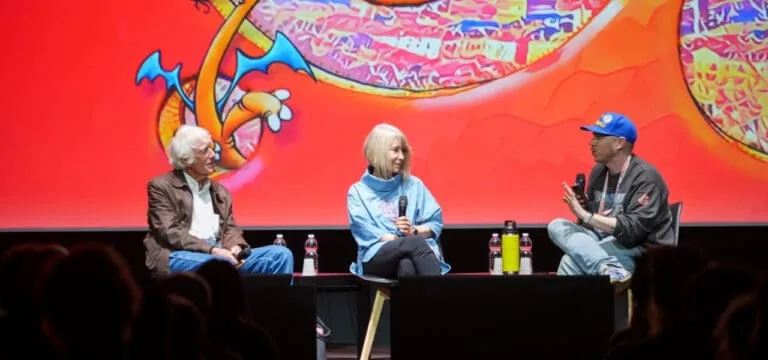
作者在参加都灵 View Conference 后反思,虽然活动提供了关于动画与 VFX 制作的精彩访谈,但 AI 销售宣讲不断干扰。NVIDIA 与 Runway 的对话被宣传为亮点,凸显了商业野心对艺术讨论的侵蚀,令创作者感到疲惫。
NVIDIA 推出开源命令行工具 gds-diag,用于评估环境、识别问题并优化 GPUDirect Storage 部署。该工具支持自然语言交互的 Agent Skill,可自动执行诊断工作流并提供修复建议,帮助开发者在数据中心和云环境中高效配置 GPU 存储加速路径。
文章介绍了一种在 NVIDIA GPU 上使用 FP32 Tensor Core 技术加速机器学习原子间势能(MLIP)推理的方法。通过将 FP32 操作分解为低精度组件并在 Tensor Core 上计算,该方法在不损失数值精度的前提下显著提升了矩阵乘法吞吐量,从而优化了大规模分子动力学模拟的性能与稳定性。
NVIDIA 宣布在 GTC Berlin 发布支持八个 DGX Spark 节点的集群方案,将统一内存扩展至 1 TB。该配置可本地部署 GLM-5.3 等千亿参数前沿模型,实现交互式推理与多智能体编排,为开发者提供强大的本地高性能计算能力。
本文介绍 NVIDIA TensorRT 11.1 中发布的全局性能调优器,旨在通过自动化的端到端性能调优突破单一构建路径限制。文章详细阐述了将调度策略表示为可搜索构建路线的算法与架构设计,并提供了使用最佳实践,以解决深度学习编译器中的关键调度挑战。
文章介绍 TensorRT 11.1 引入的全局性能调优器,解决神经网络编译中调度策略耦合导致的性能预测难题。通过数学框架与实例,阐述如何自动平衡图变换、融合及量化等决策,在满足精度约束下实现端到端推理性能的最优配置。
NVIDIA Mission Control 2.5 将自主恢复引擎扩展至 Kubernetes 工作负载,取代传统的 Slurm HPC 限制。该功能通过自动检测、诊断和恢复异常,帮助 AI 工厂从被动运维转向自愈基础设施,显著提升大规模分布式训练集群的韧性与可用性。
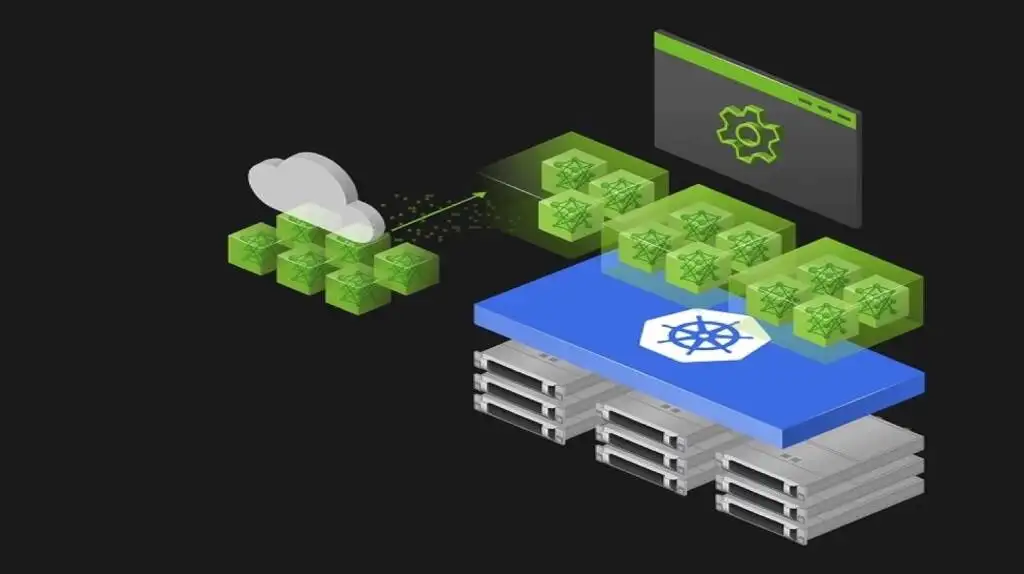
NVIDIA Minerva 平台通过收集全栈遥测数据,构建动态知识图谱并应用机器学习,将分散的故障信号关联为高保真事件。这解决了 AI 工厂中因细微硬件退化导致的训练延迟问题,显著减少跨团队排查时间,从而最大化 GPU 产出效率。
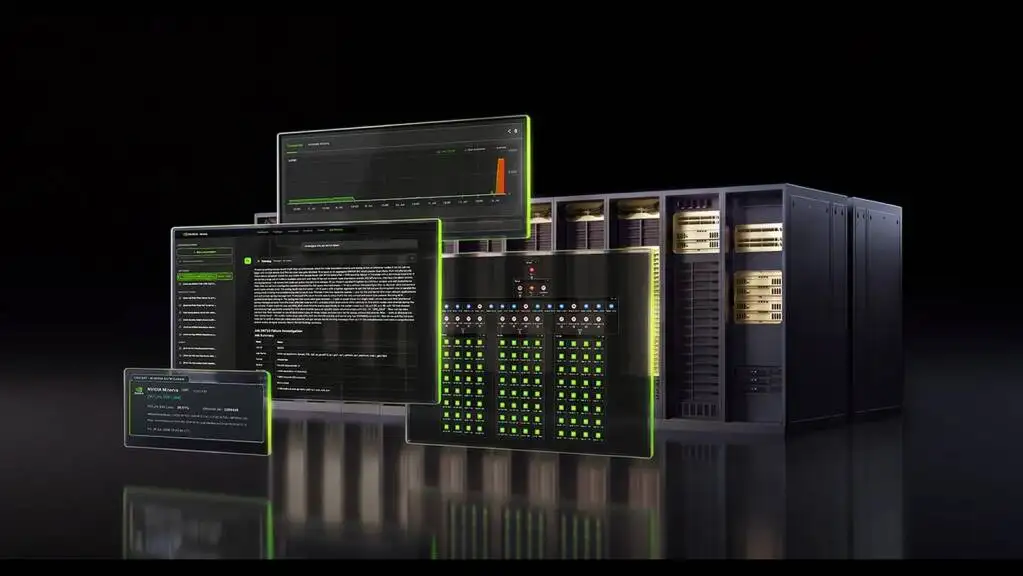
NVIDIA 发布 CUDA 13.4,新增透明内存边界强制执行功能。结合开源 GPU Fractioning Operator 与 KAI Scheduler,可在 Kubernetes 集群中为每个工作负载精确限制显存用量,解决多租户场景下 GPU 资源闲置问题,提升基础设施利用率。
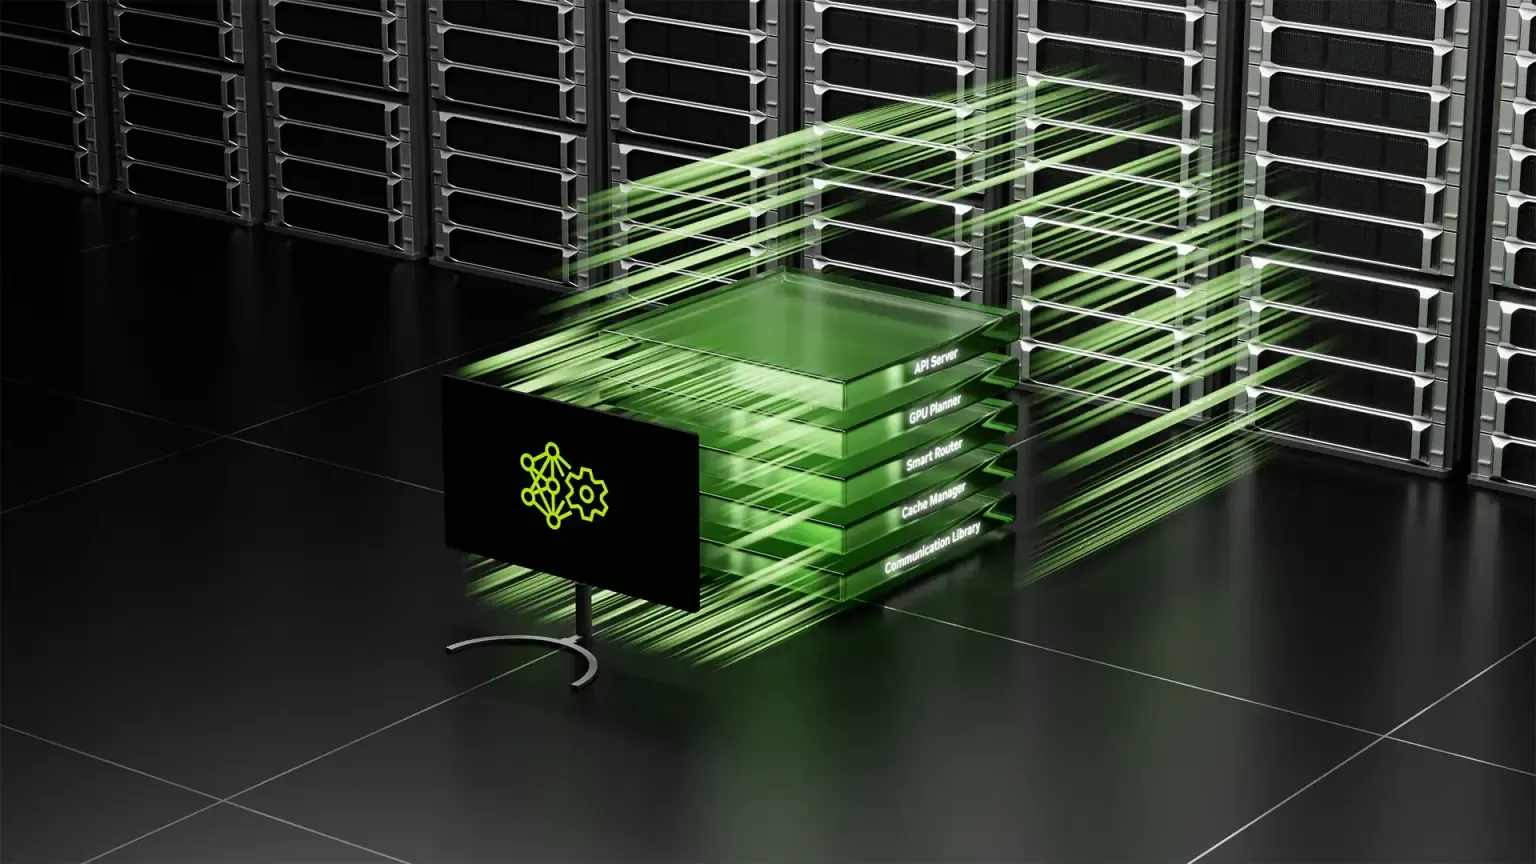
NVIDIA 发布 RTX Spark 平台,基于 Blackwell GPU 和 Grace CPU,专为 AI 开发与游戏打造。该技术支持 DLSS 5 的 3D 引导神经渲染、动态多帧生成及 ACE AI 角色技术,显著提升性能并降低 VRAM 占用,为开发者提供完整的 CUDA 栈与优化工具。