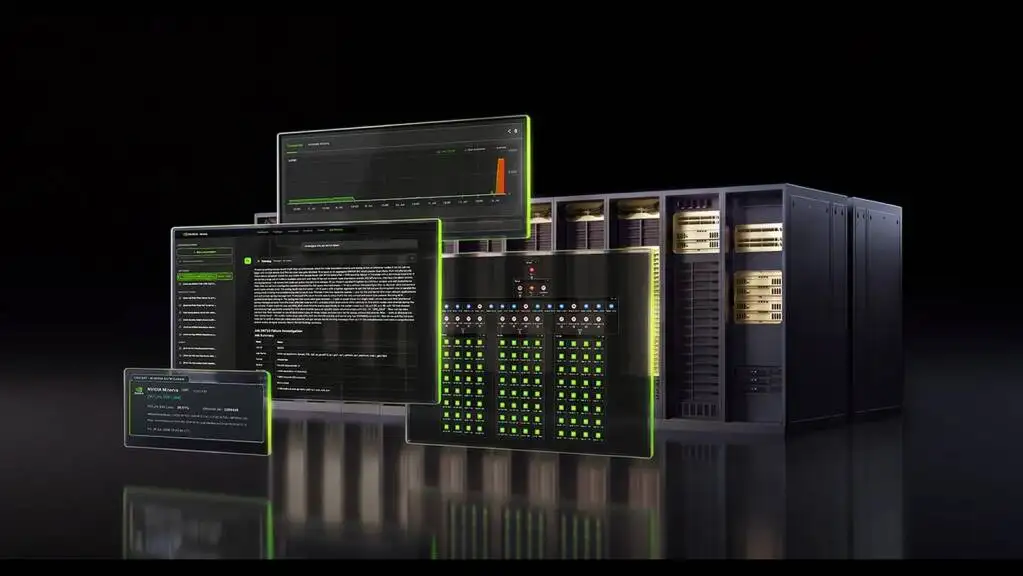
NVIDIA Recovery 自动化恢复分布式训练中断
NVIDIA Recovery 是 DSX OS 中的开源服务,通过自动检测故障、隔离资源并从检查点重启,解决大规模分布式 AI 训练中因硬件或软件问题导致的任务中断。该方案减少人工干预,维持集群算力利用率并提升有效训练进度。
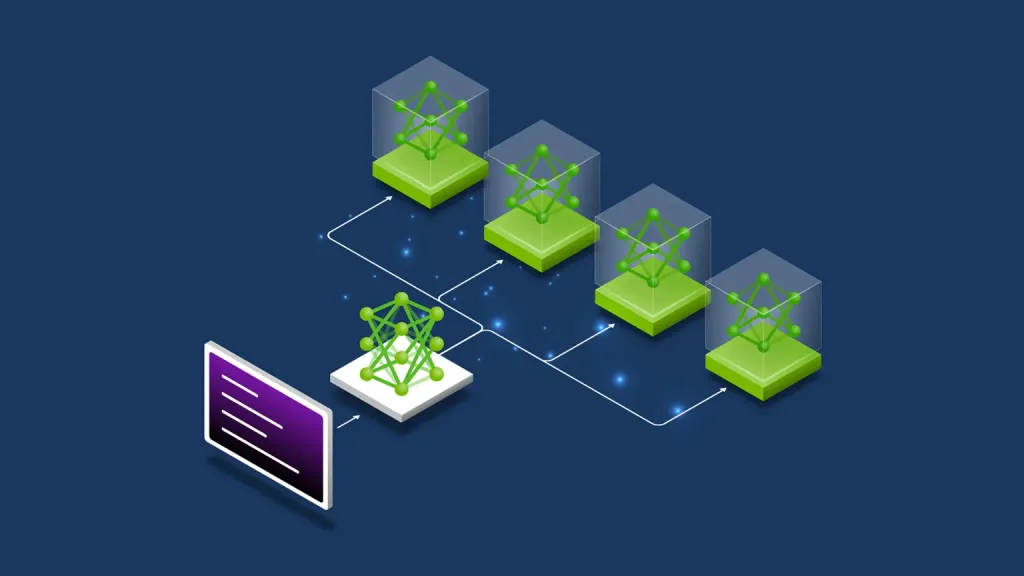
NVIDIA Recovery 是 DSX OS 中的开源服务,通过自动检测故障、隔离资源并从检查点重启,解决大规模分布式 AI 训练中因硬件或软件问题导致的任务中断。该方案减少人工干预,维持集群算力利用率并提升有效训练进度。
NVIDIA 宣布在 GTC Berlin 发布支持八个 DGX Spark 节点的集群方案,将统一内存扩展至 1 TB。该配置可本地部署 GLM-5.3 等千亿参数前沿模型,实现交互式推理与多智能体编排,为开发者提供强大的本地高性能计算能力。
NVIDIA Minerva 平台通过收集全栈遥测数据,构建动态知识图谱并应用机器学习,将分散的故障信号关联为高保真事件。这解决了 AI 工厂中因细微硬件退化导致的训练延迟问题,显著减少跨团队排查时间,从而最大化 GPU 产出效率。