
五大设计协同策略:让 AI 工厂中的每一字节发挥最大价值
2026年11月5日
在 AI 工厂中,高带宽内存(HBM)是速度最快、成本最高、竞争最激烈的存储层级。每一字节的冗余权重拷贝、空闲会话的 KV Cache,或重新计算的前缀,都是未能用于生成 Token 的浪费。如今的问题已不再是 GPU 拥有多少内存,而是每一字节能交付多少有效工作量。
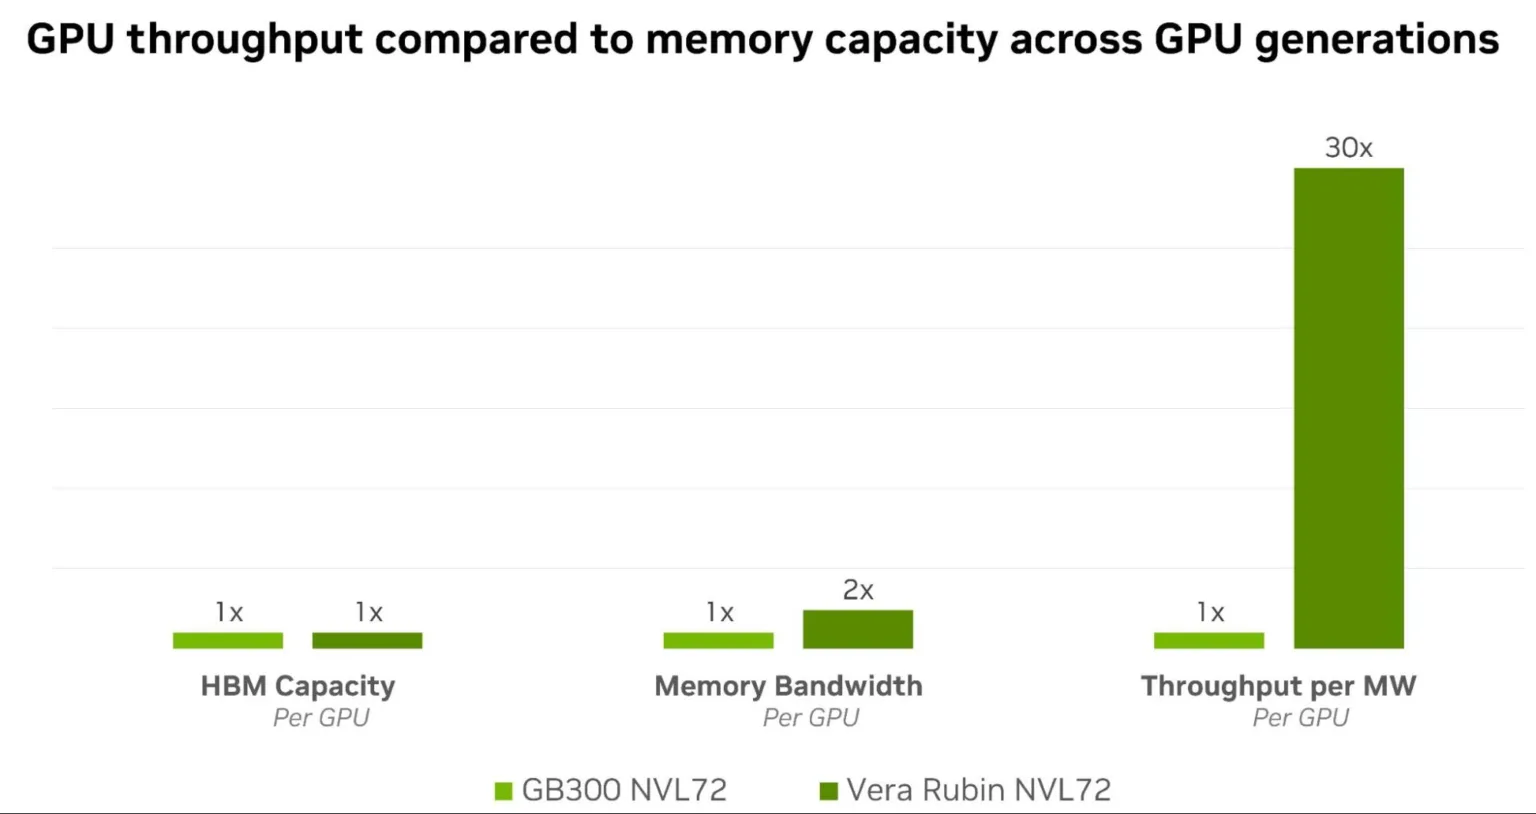
下图图 1 的代际数据揭示了原因。从 GB300 到 NVIDIA Rubin,显存容量维持在 288 GB,而带宽已提升至 19.2 TB/s。智能体每兆瓦吞吐量的增长则快得多。在 SemiAnalysis AgentX 平台中(该平台会回放带有真实工具调用间隔和不断增长的上下文的编码智能体会话),NVIDIA Vera Rubin NVL72 可为每位用户以每秒 160 个 Token 的速度,实现比 GB300 NVL72 高出高达 30 倍的每兆瓦吞吐量。
图 1. 从 GB300 NVL72 到 Vera Rubin NVL72,GPU 吞吐量提升了 30 倍,而 HBM 容量基本保持在同一水平。
仅靠容量无法解释为何在单卡 288 GB 不变的情况下实现了 30 倍的提升。关键在于每一字节能交付的有效工作量不同。
NVIDIA 将这一问题视为跨架构的协同设计挑战,涵盖 GPU 架构、Scale-up 互联、推理服务软件、CPU 以及存储。本文探讨五种协同设计如何最大化每一字节内存的价值,从编码单个权重的比特,到跨智能体轮次与节点保存并复用上下文的共享存储。
1. NVFP4 如何在更少的字节中存储更多智能?
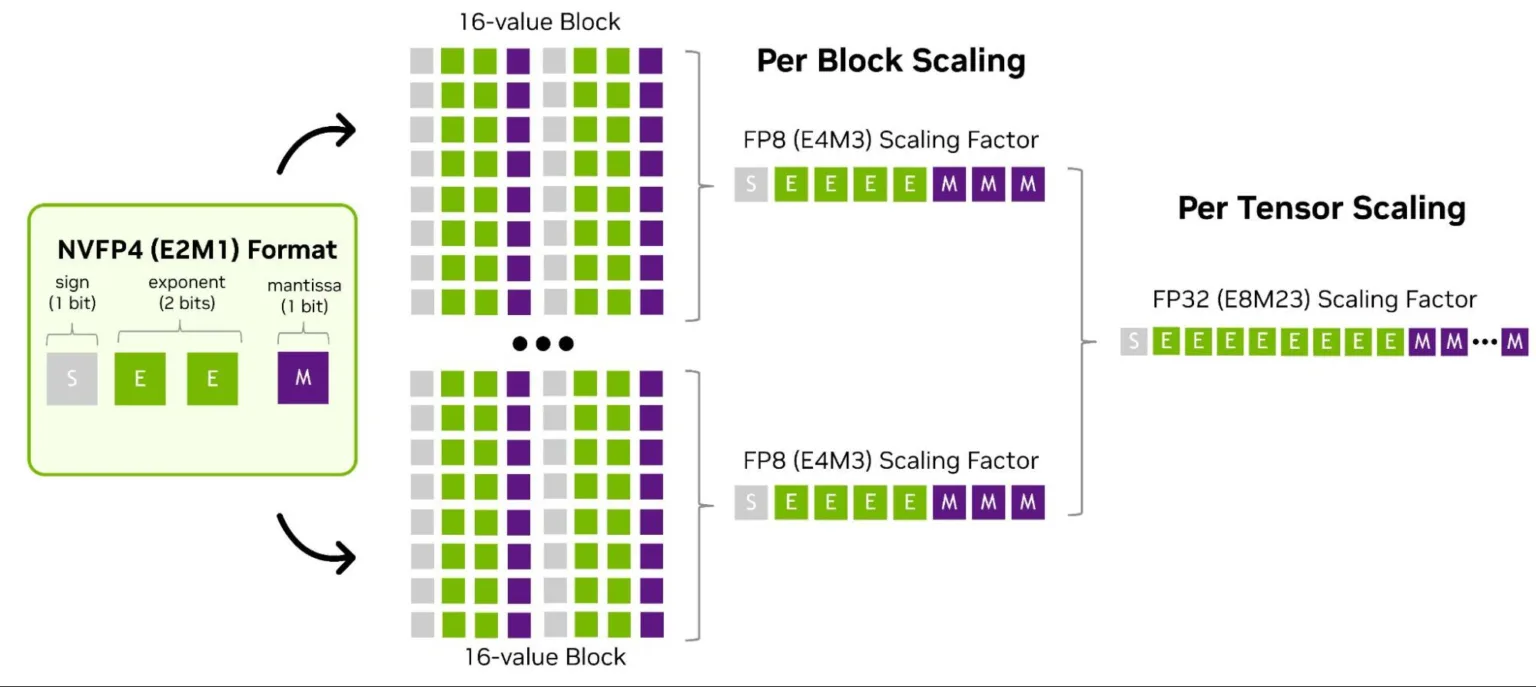
提升字节价值的直接方法是缩小每个值的体积,同时不丢失其编码信息。NVFP4 采用 4 位 E2M1 元素配合两级缩放机制来实现这一点:每 16 个值组成的微块共享一个 FP8(E4M3)缩放因子,其上层再叠加一个张量级 FP32 缩放。该格式既足够紧凑以释放大量 HBM 空间,又足够精细,能在朴素 4 位格式失准的关键区域保留精度。
图 2. NVFP4 将 4 位数值与块级及张量级缩放相结合。
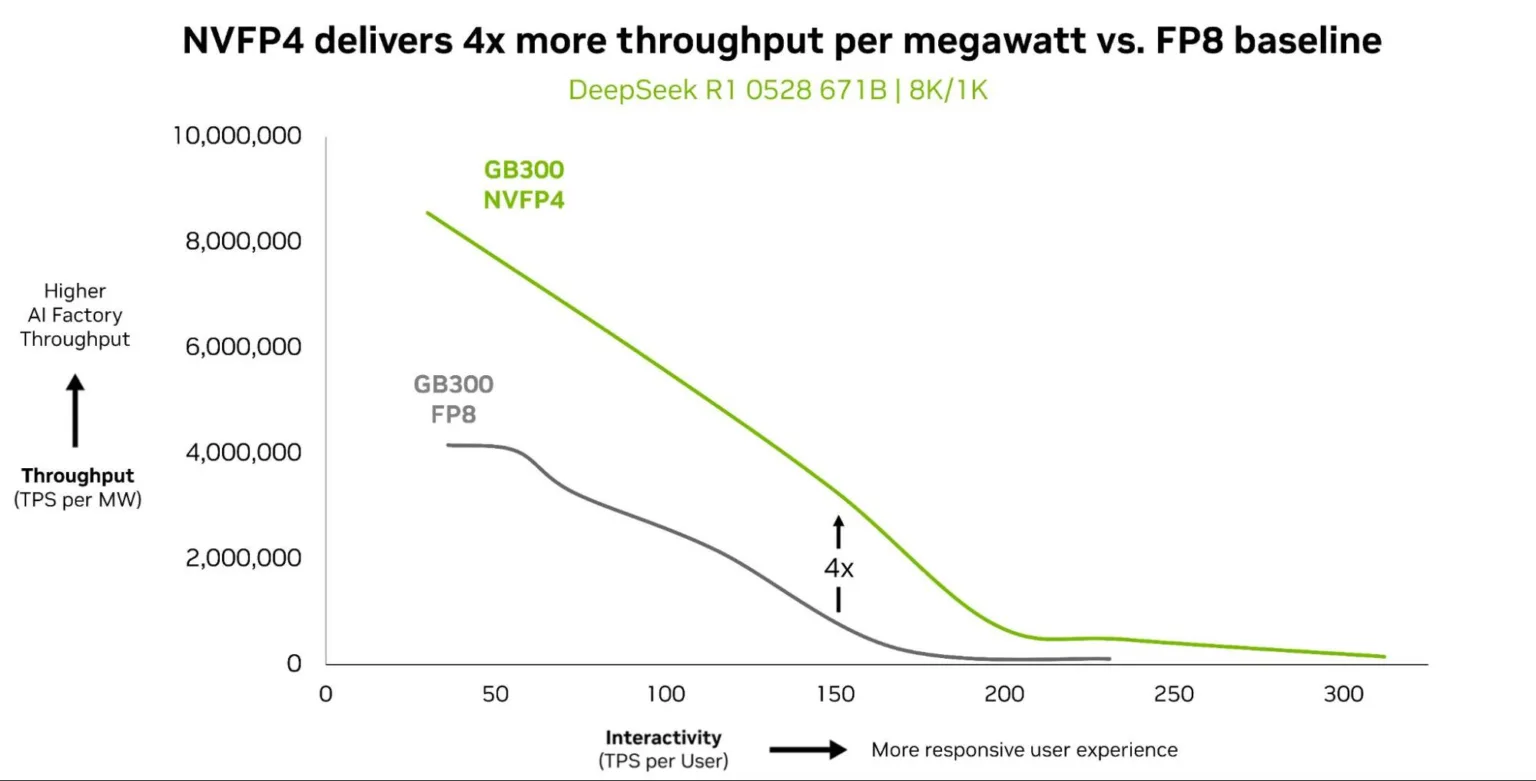
应用于权重时,相较于 FP16,NVFP4 可将模型体积缩减约 3.5 倍;相较于 FP8,可缩减约 1.8 倍。这为智能体推理最迫切的需求腾出了内存空间:更多的 KV Cache 容量、更大的批次尺寸以及更高的并发度。目前,NVFP4 已成为对精度要求严格的开源智能体基准测试的默认精度标准,包括 AA-AgentPerf、SemiAnalysis AgentX 和 MLPerf Endpoints。在这些基准测试及主流混合专家(MoE)架构上,它在保持相同交互性的前提下,可实现比 FP8 基线高出高达 4 倍的吞吐量(见图 3)。
图 3. 在 GB300 上运行 DeepSeek R1 时,NVFP4 在相同交互性下,每兆瓦吞吐量达到 FP8 的 4 倍。
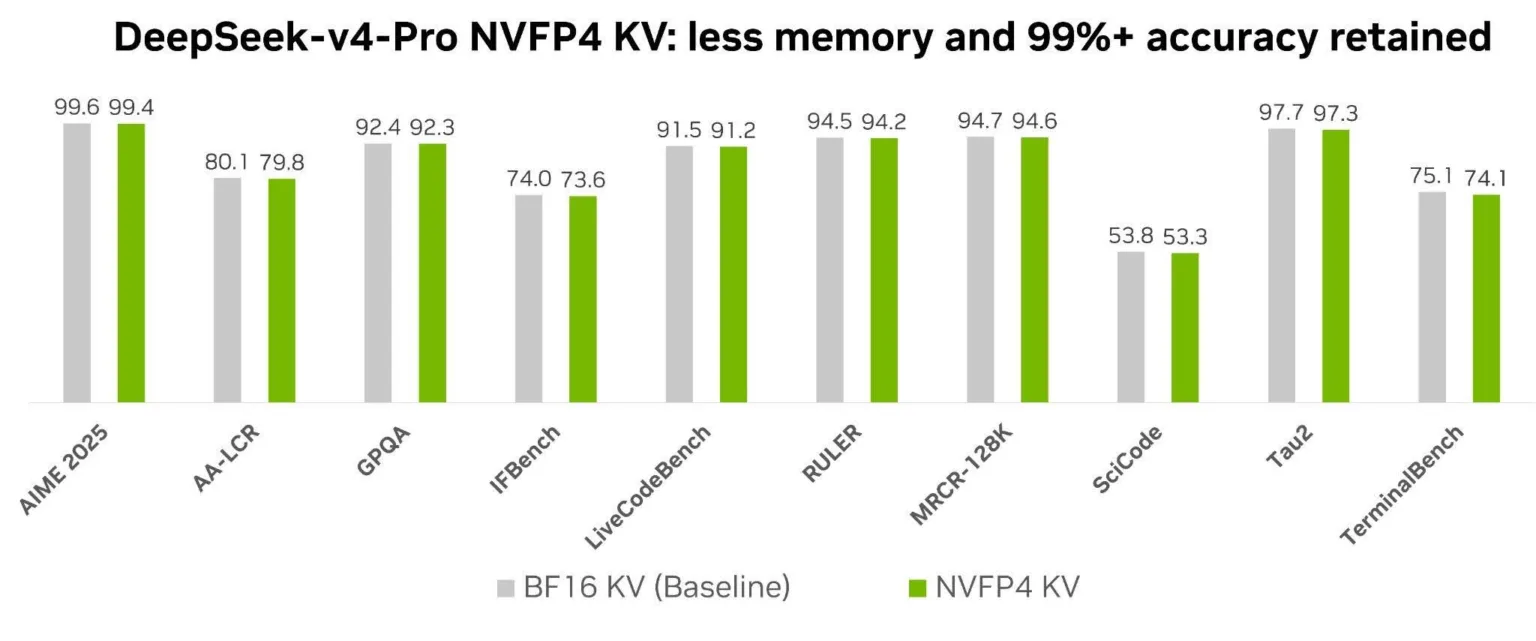
同样的原理也适用于 KV Cache 本身。与 FP8 相比,NVFP4 KV Cache 可将缓存占用减少高达 50%,因此设备上驻留的上下文量大约增加 2 倍。预填充阶段的缓存驱逐操作更少,意味着更高的缓存命中率;而更小的缓存体积则在解码阶段降低了带宽消耗。
图 4. NVFP4 KV Cache 在 10 项 DeepSeek-v4-Pro 基准测试中,保持了超过 99% 的 BF16 基线得分
NVFP4 压缩了数据体积。接下来的问题是:这些数据存放在哪里?AI 工厂又需要为它们保留多少份副本?
2. NVLink 扩展域如何将 72 块 GPU 整合为一个内存池?
MoE 模型每次仅激活部分参数,但每个专家的权重仍必须存储在 HBM 中。当专家被打包到少量 GPU 上时,每块 GPU 会将大量显存用于存放权重,导致每次解码步骤都要为 MoE GroupGEMM 付出沉重的权重加载代价。这些权重虽然驻留在内存中,却并未充分发挥作用。
NVIDIA TensorRT-LLM 中的宽专家并行(Wide-EP)技术改变了这一比例,它将专家分散到八块或更多 GPU 上。以 DeepSeek-R1 的 EP64 配置为例,每块 GPU 在每个层仅持有四个专家,即在完整模型的 14,848 个专家中,跨越 58 个 MoE 层的 232 个专家块由该 GPU 承载。每块 GPU 上的专家权重更少意味着:
- 容量:每块 GPU 可腾出更多 HBM 用于 KV Cache、更大批次以及更高并发。
- 算术强度:GroupGEMM 内核会在更多 token 间复用已加载的权重,从而提升每字节的 FLOPs。
- 负载均衡:专家并行负载均衡器(EPLB)会在前向传播之间重新分配热点与冷点专家,确保没有 GPU 显存超卖,而其他 GPU 却处于空闲状态。
图 5. GB300 NVL72 在每位用户每秒 100 个 token 的负载下,其每兆瓦的 token 吞吐量是 H200 NVL8 的 10 倍。
这之所以可行,是因为扩展域让远程数据的效用几乎等同于本地数据。每个 MoE 层都会触发全对全(all-to-all)的分发与聚合流量,若缺乏高带宽互联网络,这些集体通信操作将完全抵消前述优化带来的收益。
原文较长(约 13,179 字),完整内容请浏览更多。