边缘计算
使用全局性能调优器突破单一构建路径:扩展 NVIDIA TensorRT 性能优化(第一部分)
2026 年 10 月 23 日
部署训练好的神经网络不仅仅是将每个算子转换为 GPU 内核。这是一个存在多种合理解的编译问题。例如,NVIDIA TensorRT 在构建引擎时,会对图中间表示(Graph-IR)变换、融合、实现方式选择、内存布局以及量化做出相互依赖的决策。这一过程称为调度(Scheduling)。不同的调度策略可以在保持模型语义不变的前提下,产生截然不同的推理性能,因此调度成为深度学习编译器优化的核心环节。
没有任何一种调度策略能适用于所有模型和部署环境。加速某个网络的转换可能会拖慢另一个网络。孤立来看更快的内核,可能与图中其他位置的融合、张量布局或内存访问产生不良交互。激进的调度策略可能在提升性能的同时,违背应用的精度要求。这些耦合且高度依赖模型的效应,往往只有在完整引擎构建并测试后才会显现,使得正确策略的选择越来越难以预测。
本文是该系列文章的第一部分,旨在建立更清晰的性能优化分析思路。文章探讨了以下问题:什么让一个编译后的引擎优于另一个?为何单个看似优秀的决策会在端到端测试中失败?精度应如何约束性能优化?文中引入了 TensorRT 11.1 版本发布的全局性能调优器(Global Performance Tuner)功能,并通过直观示例与数学框架深入探讨上述问题。
全局性能调优器功能解决了什么挑战?
以下类比说明了在 TensorRT 中开发全局性能调优器功能的初衷。
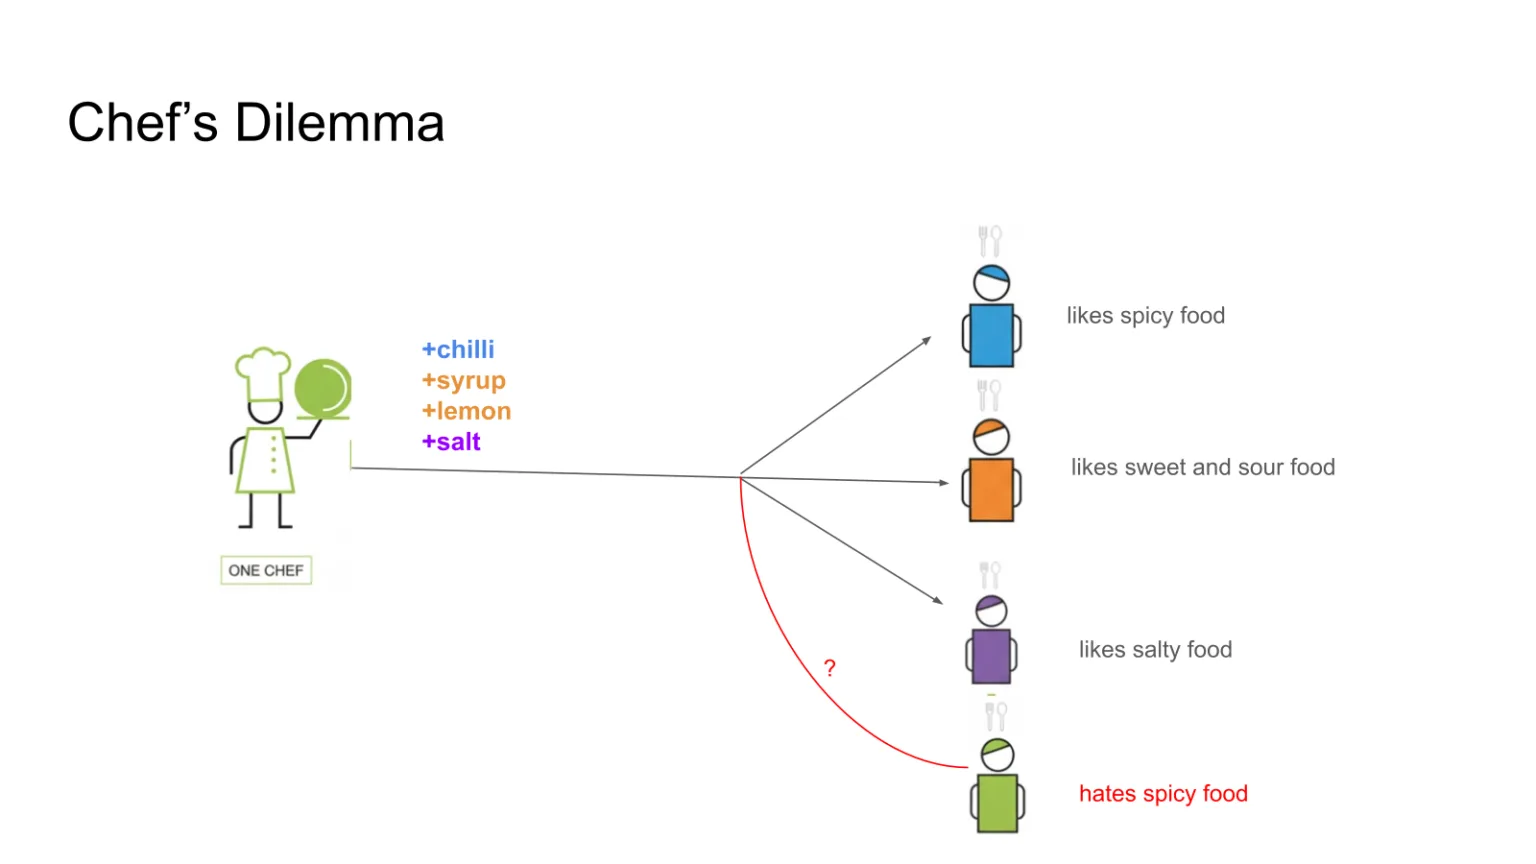
想象一位厨师,他有一道多年以来深受三位常客喜爱的招牌菜。第一位喜欢辛辣,第二位偏爱酸甜,第三位则喜欢重盐。厨师将辣椒、糖浆、柠檬汁和盐按固定比例混合成一道标准配方,同时满足这三人的口味。某天,第四位新顾客到来,但他不喜欢辛辣。保留辣椒会令新客失望;去掉辣椒又可能失去第一位老客。
厨师陷入困境的根本原因在于调味方式的扩展性不足:随着顾客群体扩大,相互影响的例外情况越来越多,为某位顾客调整配方可能会导致另一位顾客的用餐体验下降。
图 1. 固定配方无法适应冲突的顾客偏好
可扩展的解决方案是保留基础菜品,但将调味料配置化。厨师会为每位常客记录合适的调味组合。面对口味未知的新顾客,厨师会提供不同组合的免费试吃,剔除不合适的变体,最终保留顾客最满意的那一款。
图 2. 为每位客户定制口味
将此比喻映射到深度学习编译领域:TensorRT 是厨师,其共享流水线是基础食谱,可调节的编译器配置是调味料,而编译后的引擎则是成品菜肴。每个 ONNX 模型代表一位客户。性能调优提供样品供品尝,端到端性能则反映客户满意度。
历史上,TensorRT 的性能优化通常从内部关键绩效指标(KPI)模型开始。工程师会深入研究这些工作负载,识别可优化的模式,并将发现转化为启发式规则,嵌入到 TensorRT 的默认调度策略中。每条启发式规则都凝聚了专家经验,使用户能够自动受益于在代表性模型上发现的优化方案。
随着模型和部署环境的多样化,这种方法引发了与上述比喻类似的扩展性问题。源自某个内部 KPI 模型的启发式规则加入共享策略后,可能有助于熟悉的工作负载,却会导致未见过的外部模型性能回退。增加额外的检查或异常处理或许能保护该模型,但反复重复此过程会使调度逻辑越来越难以扩展。
该问题主要表现为以下三种相关形式:
- 启发式规则蔓延:每个针对特定模型的新启发式规则都会引入一条新规则,必须理解并维护其与现有规则的交互关系。随着规则不断累积,代码将变得难以维护,且对某一类模型的改进可能会无意中影响另一类模型。
- 性能与精度纠缠:低精度内核及其他激进优化手段虽能提升性能,但可能引入超出应用可接受容差的数值差异。选择更高精度可降低此类风险,但会牺牲性能。因此,性能与数值可接受度往往无法完全独立地同时优化。
- 性能定制化需求:适用于某款模型或 GPU 的调度策略,未必适用于其他组合。若将所有成功的选择都编码进单一的全局调度策略中,将难以高效地将 TensorRT 专门化,以应对不断扩展的外部模型、硬件平台及应用需求。
调优为启发式优化提供了一种可扩展的补充方案。
深度学习编译器性能的数学理论
本节旨在构建深度学习编译器性能的抽象数学模型。其目的是厘清两个根本性问题:
- 编译器能够为某模型生成哪些可执行文件
- 编译器如何从这些可能性中选择一种以实现最优性能
概念:模型与模型空间
设 表示一个模型, 表示所有待考虑模型的集合,称为模型空间:
在此语境中,模型是对待编译计算的抽象描述。其具体表现形式可以是 ONNX 计算图、通过 TensorRT API 构建的网络、PyTorch 模型,或是其他能够完整指定模型计算逻辑的前端表示形式。
概念:解(Solution)与解空间(Solution Space)
给定输入模型 ,深度学习编译器会为目标硬件构建一个可执行输出,该输出被称为“解”。同一模型在不同调度策略下通常可被编译为不同的解。设 表示其中一个解, 表示所有可能解的集合,称为解空间。
解是目标硬件上可执行计算的抽象。具体而言,解可以是一个 TensorRT 引擎,或是一组序列化 GPU 内核的 cubin 文件。从更抽象的层面来看,解也可以是编译器的中间表示(IR),前提是该表示能够在后续编译流程中唯一确定最终的可执行文件。
每个解还定义了从模型输入域到输出值域的映射函数:
此处 ((x, y)) 是实现该神经网络的 GPU 内核序列的一组输入输出对。在这一抽象层级上,模型描述的是预期的计算逻辑,而解则描述了在目标硬件上实现该计算的一种特定方式。
确定性原则(Principle of Determinism)
表述:当确定性程序及其完整的执行环境均保持不变时,该程序具有固定的底层运行时间。
该原则是性能分析的一项建模假设。严格来说,执行环境包含输入数据、目标设备、软件栈、GPU 频率、温度、功耗状态、系统负载以及其他可能影响运行时间的条件。在实际应用中,并非所有环境变量都能被完美控制,因此多次测量的运行时间会呈现噪声。若将该干扰建模为独立的高斯噪声,则多次测量结果的平均值即为底层平均运行时间的最大似然估计。
一旦执行环境在抽象所需的层级上被固定,每个解便可对应一个特征运行时间。这种对应关系使得运行时间能够被表示为一个数学函数。
概念:运行时间函数(Run Time Function)
运行时间函数 将每个解映射到其在固定执行环境下、指定目标设备上的运行时间:
由于环境被视为固定不变,因此在符号表示中予以省略。
概念:构建器算法(Builder Algorithm)
构建算法(也称为性能调度器)是一种将模型空间映射到解空间幂集的函数。当输入特定模型时,构建算法会根据给定的精度要求输出一个解空间集合。
在上述精度条件中,输入-输出对 被视为参考值, 表示精度容差阈值。参考数据、比较指标和容差均被视为固定上下文,因此不再作为 的参数显式列出。
理想情况下,构建算法应生成足够丰富的解集,以包含最优解 ,即建模解空间中速度最快的可行解。
概念:搜索算法
搜索算法(也称为解空间求解器)是一种将解空间的幂集映射到解空间本身的函数。当输入一组候选解时,搜索算法会从中挑选一个解作为输出。
需要注意的是,在实际应用中,搜索算法可能会从解空间中选出次优解。在 TensorRT 中,这种次优性至少可能源于以下两个方面:
- 搜索过程中使用的启发式规则:启发式方法可能在候选解被评估为完整引擎的一部分之前将其剔除。例如,构建器可能会根据输入模型某一层级的通道维度阈值,过滤掉某些卷积策略。如果某个被过滤的策略本应参与构成最快的端到端解决方案,搜索算法将无法再发现该最优解。
- 局部分析与端到端执行之间的差异:在构建引擎期间,内核候选项可能在策略选择阶段被单独分析;然而,推理时的性能是针对完整引擎进行测量的。孤立运行的内核与作为更大计算图一部分运行的相同内核,其执行环境并不完全一致(例如 NVIDIA Blackwell GPU 中使用的自适应网格尺寸技术)。因此,单独测量的内核运行时间之和不一定等于端到端的总运行时间。
在理想情况下,构建算法生成的候选集包含 ,且搜索算法能够可靠地选中它:
因此,深度学习编译器可以用算法元组 ((A, B)) 来表示,其中 负责生成候选解, 负责从中进行选择。然而在实际实现中,候选解的生成、剪枝、性能剖析与选择过程可能紧密耦合。因此,在编译器架构中, 与 之间的边界可能并不明确。
设 (B^) 表示构建器算法族中的最优构建算法,(A^) 表示搜索算法族中的最优搜索算法。理想的编译器将实现元组 ((A^, B^))。对于任意输入模型,该元组都会生成一个包含全局最优解的候选集,并可靠地将其找出:
在数学抽象层面,(A^*) 的一种可能实现是暴力搜索算法——即评估候选集中的每一个解,并选择运行时间最低的那个:
尽管在构建时间预算有限时,应用暴力搜索算法并不总是可行的,但构建时间与推理性能之间可能存在权衡。此处使用 (A^*) 来代表那些给定任意输入模型时必定能返回最优解的搜索算法。
构建 (B^) 才是更根本的挑战。即使是最理想的搜索算法,也无法选出构建器从未使其可达的解。与其期望一步到位地构造出 (B^),不如通过扩展和优化编译器可用的构建路径,逐步逼近它。
全局性能调优器建模
本节将编译过程建模为一系列编译器 Pass,随后展示可定制的构建路径如何为精度感知的性能调优提供基础。
深度学习编译器建模
与传统编译器类似,深度学习编译器可被视为一系列 Pass 的序列,每个 Pass 都将一种中间表示(IR)转换为另一种。如前所述,IR 与最终的可执行二进制文件存在一一映射关系;因此,可将 IR 视为一种解。基于此抽象,令 表示从解空间到解空间的 IR 自映射:
(f(s) = s')
深度学习编译器的构建算法可建模为一系列 Pass,用于将一个解转换为另一个解:
构建算法 是一个函数复合体,其形态类似于模型遍历的路径,经过变换后进入解空间,因此 也可称为构建路径。
请注意以下几点:
严格来说,至少有一个编译器阶段(例如最终的代码生成转换)会将模型空间 映射到可执行解空间 。然而,编译器阶段并非总是完全解耦的,中间表示(IR)可以被视为唯一标识由剩余固定流水线生成的引擎。因此,将这些阶段建模为广义解状态空间上的变换,提供了一种有用的简化方法。
某些编译器阶段在功能上不可或缺,但不参与所研究的性能选择。这类与性能无关的阶段可视为恒等映射,或从路线的可调部分中省略,因为它们无法区分不同的构建路线。
乍看之下,上述组合似乎暗示一条构建路线仅生成一个解(即构建出的引擎)。实际上,TensorRT 编译流水线在生成最终引擎前,可能会考虑并筛选大量潜在策略。由于算法 和 紧密耦合,候选方案的生成过程在很大程度上隐含于该组合之中。该公式描述的是最终选定的解,而非过程中考虑过或被丢弃的每一个候选方案。
可定制构建路线
性能分析与优化的经验表明,有效的调度策略依赖于具体模型。即使在同一目标 GPU 上运行,不同模型也能从各个编译器组件的不同选择中获益。因此,所有模型的最优解未必都源自同一条通用构建路线。
因此,构建路线应当支持定制,以便调度决策能够适配具体模型及其部署环境。这种可调式的构建算法可称为可定制构建路线。
例如,假设有两个模型 和 (m'),以及一组可用的构建路线:
这两个模型无需共享同一条最优路线。模型 可能通过 获得最佳结果,而模型 (m') 则可能通过 达到最优:
全局性能调优器以可定制构建路线的理念为基础。针对每个候选解,它会依据指定的精度标准验证输出结果,并测量端到端推理性能。在所有满足精度要求的解中,搜索算法会从扩展后的解集中选出运行时间最短的可行解。
以下原则定义了该框架:
- 精度感知调优:以端到端精度作为约束条件,指导性能调优。
- 可定制构建路线:使构建路线支持定制,让调度策略能够适配每个模型及部署环境。
庞大的解空间:构建丰富的可行解集,随后从中筛选出数值差异保持在指定容差范围内的最快候选方案。
全局性能调节器(Global Performance Tuner)的数学表示可写为:
\mathcal{B} = \{B_1, B_2, \dots, B_n\}
s^* = A(B_1(m) \cup B_2(m) \cup \dots \cup B_n(m))
了解更多
欲了解更多内容,请参阅全局性能调节器的官方文档,并阅读本系列的第二部分。该部分详细阐述了全局性能调节器的算法与架构设计,以及最佳使用实践。