
Agentic AI / Generative AI
Running Frontier-Class AI Models Across 8 NVIDIA DGX Spark Nodes
2026 年 10 月 22 日
AI 开发者不再仅仅运行单个模型,而是并行编排多个模型、串联推理调用,并尝试那些需要数百 GB 内存的前沿架构。NVIDIA DGX Spark 旨在将 AI 开发带入桌面端,如今您还能将更多的 Spark 节点连接在一起。
在柏林 GTC 大会上,NVIDIA 宣布正式支持八节点 DGX Spark 集群,将统一内存扩展至 1 TB,从而为前沿模型、多智能体工作负载以及近线性预训练打开大门——所有计算均可在本地完成。
NVIDIA Sync 让集群搭建变得轻松。其 Cluster Assistant 负责设置与设备管理。NVIDIA Sync 对八节点集群的支持将于今年年底推出。
继续阅读下文,了解随着集群规模扩大,推理、编排与训练的基准测试数据是如何扩展的。
Run larger, newer frontier-class models
八节点集群最大的优势在于内存容量。单个 DGX Spark 提供 128 GB 统一内存;四个节点可达 512 GB;八个节点则达到 1 TB。这一容量使得此前无法在四节点系统上启动的一类模型得以运行,其中包括来自 Z.ai 的完整 GLM 5.3(753B)模型。
除了能够容纳这些模型外,该集群还专为交互式服务而设计。作为早期示例,我们在八节点集群上运行了 GLM 5.3 Flash,测得生成速度约为每秒 80 个词元(TPS),足以满足针对前沿混合专家(MoE)模型进行本地交互式开发的需求。
完整的 GLM 5.3(753B)检查点可在 8×128 GB 集群上运行,使其成为您可在本地部署的最大开源模型之一。
| 并发数 | Prefill 总词元/秒 (TPS) | Prefill 每用户词元/秒 (TPS) | Decode 总词元/秒 (TPS) | Decode 每用户词元/秒 (TPS) |
|---|---|---|---|---|
| 1 | 1,600 | 1,600 | 313 | 314 |
| 4 | 1,600 | 750 | 512 | 181 |
| 8 | 1,600 | 473 | 671 | 818 |
表 1. 八节点 DGX Spark 集群上完整 GLM 5.3(nvidia/GLM-5.3-NVFP4)的性能表现。该模型在 NVFP4 精度下约占 470 GB,使用 MTP3 在并发数为 1、4 和 8 时进行测试。Prefill 阶段按每个请求 8K 输入序列长度(ISL)测量。
Faster collectives with a Spark-optimized backend
张量并行推理会将其相当一部分时间花费在 all-reduce 等集合通信操作上。在通过交换机连接的集群中,我们一直在评估一种针对 Spark 优化的集合通信后端 RoCEnante。该后端可降低本地 AI 硬件上进行张量并行解码时典型的小消息、低并发、中等秩数量模式的集合通信延迟。
该后端实现了先进行全到全(all-to-all)交换,随后进行本地归约的流程。每个秩(rank)会将其输入共享给其他所有秩,然后在本地累加输入值。单个 GPU 内核负责协调交换与归约过程。
主要优势在于减少了通信步骤。环形 All-Reduce 在多个轮次中于相邻进程之间传递数据。该方法直接与所有对等节点交换数据,避免了转发链。对于消息较小且进程数量适中的场景,这能有效降低延迟。
代价是数据移动量增加。每个进程需将完整输入发送给所有对等节点,并自行完成所有输入的归约操作。随着消息体积或进程(节点)数量的增长,额外的流量开销会变大,这使得环形 All-Reduce 的带宽效率显得愈发突出。如果需要支持高并发、更大规模的集群或环形拓扑结构,NVIDIA 集合通信库(NCCL)的表现会更佳。
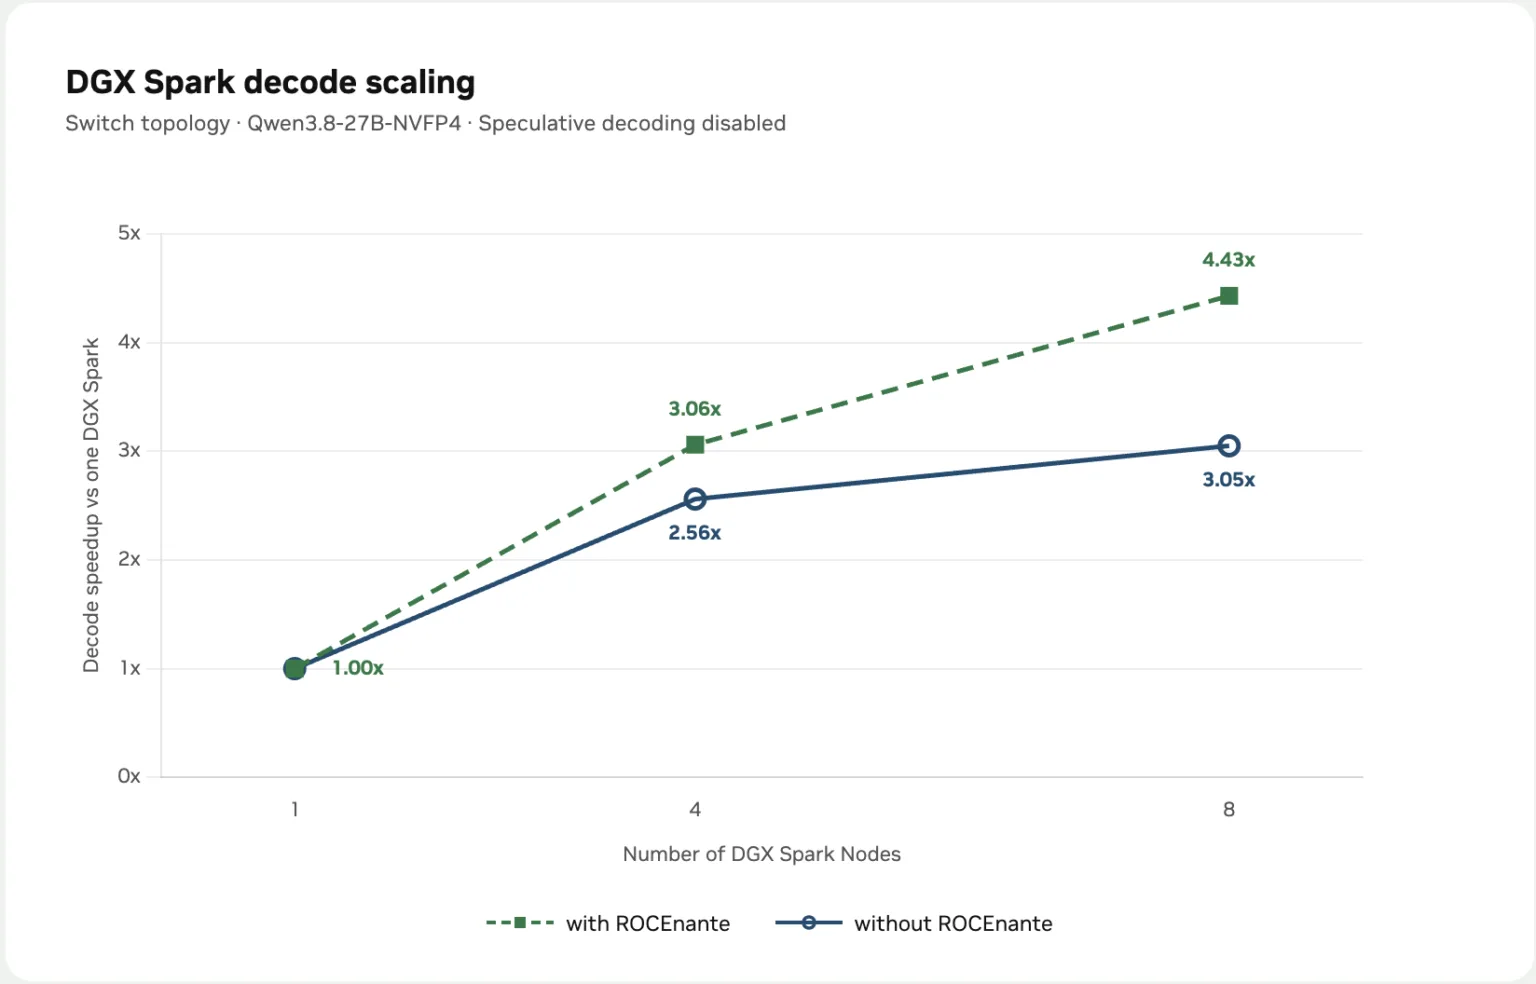
图 1. 在交换机拓扑上使用 Qwen3.8-27B-NVFP4(已禁用投机解码)时,Spark 解码扩展在启用与未启用 ROCEnante 下的对比。在八个 Spark 节点上,ROCEnante 带来了 4.43 倍的速度提升,而未启用时为 3.05 倍——扩展效率提升了 45%。
在实际测试中,我们在四个节点(NVFP4)上观察到预填充吞吐量提升约 5%,解码吞吐量提升约 21%;在非量化模型的八个节点上,解码吞吐量提升约 18%。这与前述的延迟与带宽权衡趋势一致。该后端已合并至 FlashInfer,若启动测试失败,会自动透明地回退到 NCCL。
该后端仅适用于交换机连接的拓扑结构,因为它依赖每个节点之间的直接点对点交换。它并非 NCCL 的替代品;随着集群规模与并发量的增长,NCCL 仍是官方支持的默认选项,也是更优的选择。原始的一次性 All-Reduce 方案由社区贡献(Jason Cook/el8)。
二、四、八:扩展集群规模
低延迟的 NVIDIA ConnectX-7 网卡与融合以太网上的远程直接内存访问(RoCE)通信协议,使 DGX Spark 节点能够高效交换张量。因此,您可以将模型扩展到更多节点以适配内存,并进一步提升吞吐量。为隔离集群扩展行为并排除上下文依赖干扰,我们在一到八个节点上对未启用投机解码/MTP 的密集型 Qwen3.8-27B(NVFP4)模型进行了基准测试:
原文较长(约 9,292 字),完整内容请浏览更多。