
网络与通信 2026年10月26日
NVIDIA Minerva 如何将遥测数据混乱转化为极致 GPU 产能AI 工厂是迄今为止技术最复杂的运行环境之一。数十万个 GPU、NVIDIA Spectrum-X 以太网互联网络(scale-out)、跨节点(scale-across)和缩容(scale-in)架构、NVIDIA NVLink 扩展(scale-up)互联网络架构、分布式调度器以及持续数周的训练任务,都在紧密同步地协同运行。即使不同团队负责各自的遥测数据,这些层级仍作为一个统一的生产系统运作。在同步分布式训练中,任务的推进速度取决于最慢的节点(rank)。单个性能下降的 GPU、网卡接口、存储设备或交换机路径,都可能让大量健康资源浪费宝贵的时间。
影响产能的故障往往十分隐蔽:某个 GPU 的温度比同侪高出几度;某块 NVMe 设备仅在持续高负载下才会出现性能衰减;某台交换机产生的暂停帧风暴(pause-frame storm),表面上看起来像是数十种毫不相关的症状。这些信号中的任何一个都不一定会突破静态阈值。但它们叠加在一起,却会导致计算拖尾节点(stragglers)、训练步耗时延长以及检查点(checkpoint)延迟。
由于证据分散在不同团队手中,故障排查变得更加困难。网络运维人员看到的是接口计数器和网络事件;计算运维人员关注的是节点和 GPU 的健康状态;机器学习团队则观察到步长时间的变化、任务失败或推理延迟的不稳定。
每种视角都是准确的,但它们之间的关联却隐藏不见。故障分级处理变成了一系列仪表板查询和跨团队交接,这可能导致原本可控的故障演变为数小时甚至数天的生产时间损失,直到受影响的节点或网络路径被最终定位。
本文介绍 NVIDIA Minerva 如何解决这些运营缺口。Minerva 是一款原生面向 AI 的 AIOps 平台,专为 AI 工厂的网络拓扑与负载而设计。
NVIDIA Minerva 在整个技术栈中收集遥测数据,将基础设施映射到动态知识图谱中的活跃任务上,应用专用机器学习算法,并将相互依赖的症状关联为高保真度的故障事件。由 AI Agent 驱动的智能助手及连接外部智能体工具的 MCP Server,为运维人员提供了一条通过实时数据进行对话式排查的路径。其目标非常务实:保留有效的 GPU 运行时长,并确保模型训练持续推进。
为何传统监控在 AI 工厂规模下会失效
基于规则的监控假设“已知指标跨越已知边界即代表已知状态”。该模式适用于明确的故障,但在所谓的“灰色故障”面前却显得力不从心。这类故障中组件依然可用,相关问题可能仅在负载下或与同侪对比时才会显现。绝对阈值可能会错过这种渐变偏移,而过于激进的阈值又会在正常负载波动时频繁告警,最终只能由值班工程师来判断哪些偏差值得关注。
规模扩大导致告警数量激增。单个物理故障可能引发接口错误、RX(接收)暂停帧、拥塞指示器、GPU 利用率变化以及作业进度变慢等现象。这些观测结果实际上描述的是同一条依赖链,但分散的仪表盘或告警系统却将它们呈现为无关事件。值班工程师会收到大量告警,需要手动进行关联分析,从海量信息中甄别有效信号,进而排查根本原因并确定受影响的作业。
对于运维工作而言,工作负载才是核心考量单元。团队必须明确哪些作业受到影响、占用了哪些资源、这些资源在物理与逻辑拓扑中的位置,以及当前行为与健康基线有何差异。随着作业的启停以及节点的排空、替换或重新上线,这些信息必须保持实时同步。若缺乏此类上下文,即便组件级仪表盘显示正常,也可能掩盖作业吞吐量低下的事实,且无法提供合理解释。
构建基础设施与工作负载的实时模型
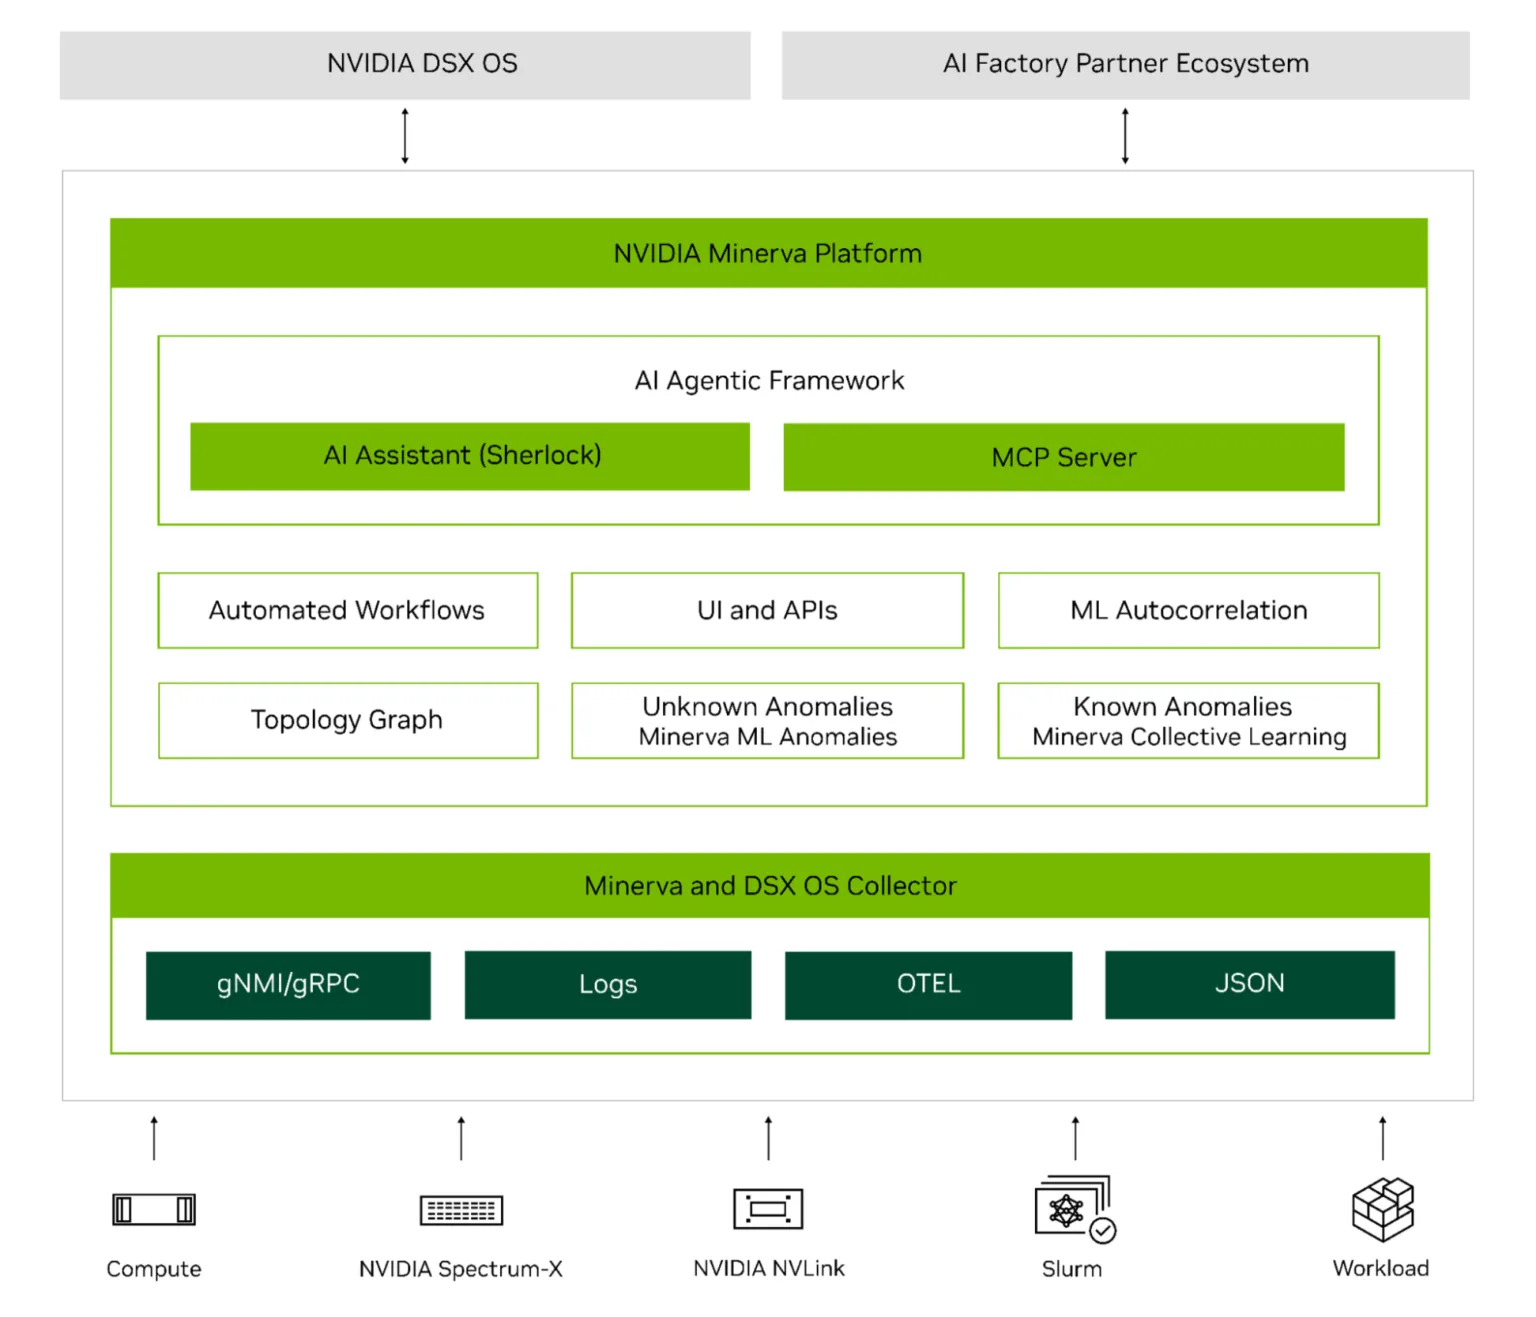
图 1. NVIDIA Minerva AIOps 可观测性平台
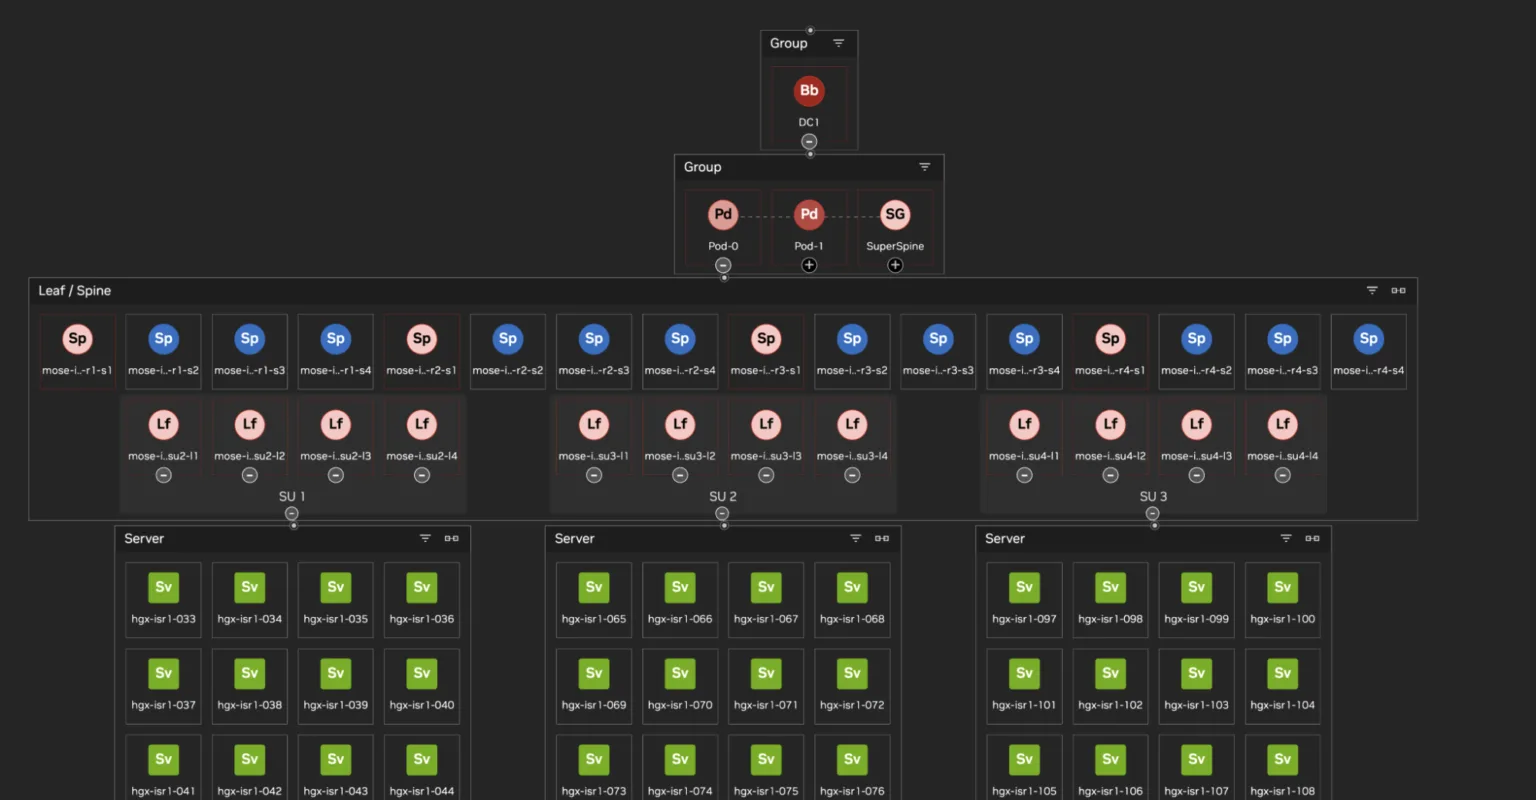
解决上述挑战需要在整个 AI 工厂范围内实现端到端的可观测性。NVIDIA Minerva 能够采集来自 GPU、Spectrum-X 和 NVLink 交换机、SuperNIC、DPU、存储设备、NVIDIA NCCL、调度器及 AI 工作负载的指标、日志与拓扑数据。自动发现机制补充了原始遥测数据所缺失的关联关系。由此生成的知识图谱对基础设施、调度器和工作负载元素进行映射,并随环境变化动态更新连接关系。该图谱可跨越多个数据中心,并支持从工厂全局视图下钻至单个接口的导航浏览。
拓扑图谱是改变排查路径的关键。若从异常接口入手,运维人员可以定位其所属节点、服务的 Fabric 路径、当前的作业部署情况,以及同一故障域内的邻近组件。若从作业 ID 出发,机器学习工程师则能沿着 GPU、宿主机、网卡、交换机及日志证据追溯工作负载的运行轨迹。网络与计算团队既可以从基础设施事件切入,查看受影响的作业;也可以反向操作,针对受影响的作业,利用 NVIDIA Minerva 深入调查根本原因。
原文较长(约 11,816 字),完整内容请浏览更多。