解锁机器学习原子间势能的 Tensor Core 性能
2026 年 10 月 29 日
原子模拟帮助研究人员理解分子和材料的行为,涵盖从化学反应、相变到机械失效的各个方面。这类模拟需要在计算成本与精度之间进行权衡。密度泛函理论(DFT)等量子力学方法能够提供精确的能量和受力,但其高昂的计算开销往往限制了它们在大规模体系或长时间模拟中的应用。
经典原子间势能函数运行速度更快,但其固定的函数形式限制了在不同原子环境下的精度与泛化能力。机器学习原子间势能(MLIPs)有助于弥合这一差距。它们利用神经网络以极低的计算成本预测势能及原子间受力,使研究人员能够在保持所需精度的前提下,研究更大规模的体系和更长的时间尺度。
然而,高效运行 MLIP 本身也带来了挑战。原子模拟对微小误差非常敏感,这些误差会随时间累积,并在计算受力时表现得最为明显,而受力正是通过对预测能量求导得到的。在分子动力学模拟中,这些受力会在多个时间步长内指导原子速度和位置的更新,因此数值精度不仅关乎物理结果的准确性,还直接影响最终轨迹的稳定性。
正因如此,尽管现代 NVIDIA GPU 通过低精度 Tensor Core 操作提供了显著更高的矩阵乘法吞吐量,许多 MLIP 仍继续使用 FP32 格式进行推理。针对 FP32 矩阵乘法的 Tensor Core 方法提供了一条缩小该差距的途径。该方法将每个 FP32 操作数分解为低精度分量,在 Tensor Core 上计算它们的交叉乘积,最后以 FP32 格式重新组合结果。此方法能够在不重新训练模型或更改其权重与架构的前提下,提升矩阵乘法吞吐量,同时保持接近原生 FP32 的精度。
在本文中,我们评估了 Tensor Core FP32 方法在实际应用中的表现,测试对象为洛桑联邦理工学院(EPFL)COSMO 实验室开发的基于 Transformer 的 MLIP——Point Edge Transformer(PET)。PET 的运行时间大量消耗在高度优化的通用矩阵乘法(GEMM)上,进一步优化的空间有限,因此它成为检验这些方法能否带来额外性能提升的严苛用例。
我们在 NVIDIA Blackwell GPU 上评估了 BF16x9 方法,在 NVIDIA Ampere GPU 上评估了 TF32x3 方法,对比了内核级与端到端分子动力学性能以及轨迹级别的行为。我们还进一步测试了 TF32x3 方法在势能平滑性、能量守恒和结构弛豫方面的表现。本文展示了这些方法如何在保持行为接近 FP32 基线的前提下加速 MLIP 推理,并概述了如何对其他对精度敏感的 科学机器学习 工作负载进行评估。
如何通过 Tensor Core FP32 弥补硬件性能差距
现代 NVIDIA GPU 在 BF16 和 TF32 矩阵乘法上的 Tensor Core 吞吐量远高于 FP32,导致低精度下的可用吞吐量与许多科学计算工作负载的精度要求之间存在差距。Tensor Core FP32 方法通过将 FP32 操作数分解为更低精度的分量,在 Tensor Core 上计算选定的乘积,并使用 FP32 累加器重新组合,从而缩小这一差距。根据具体方法与工作负载的不同,该方法能够在保持接近原生 FP32 精度的同时,充分利用更高的 Tensor Core 吞吐量。
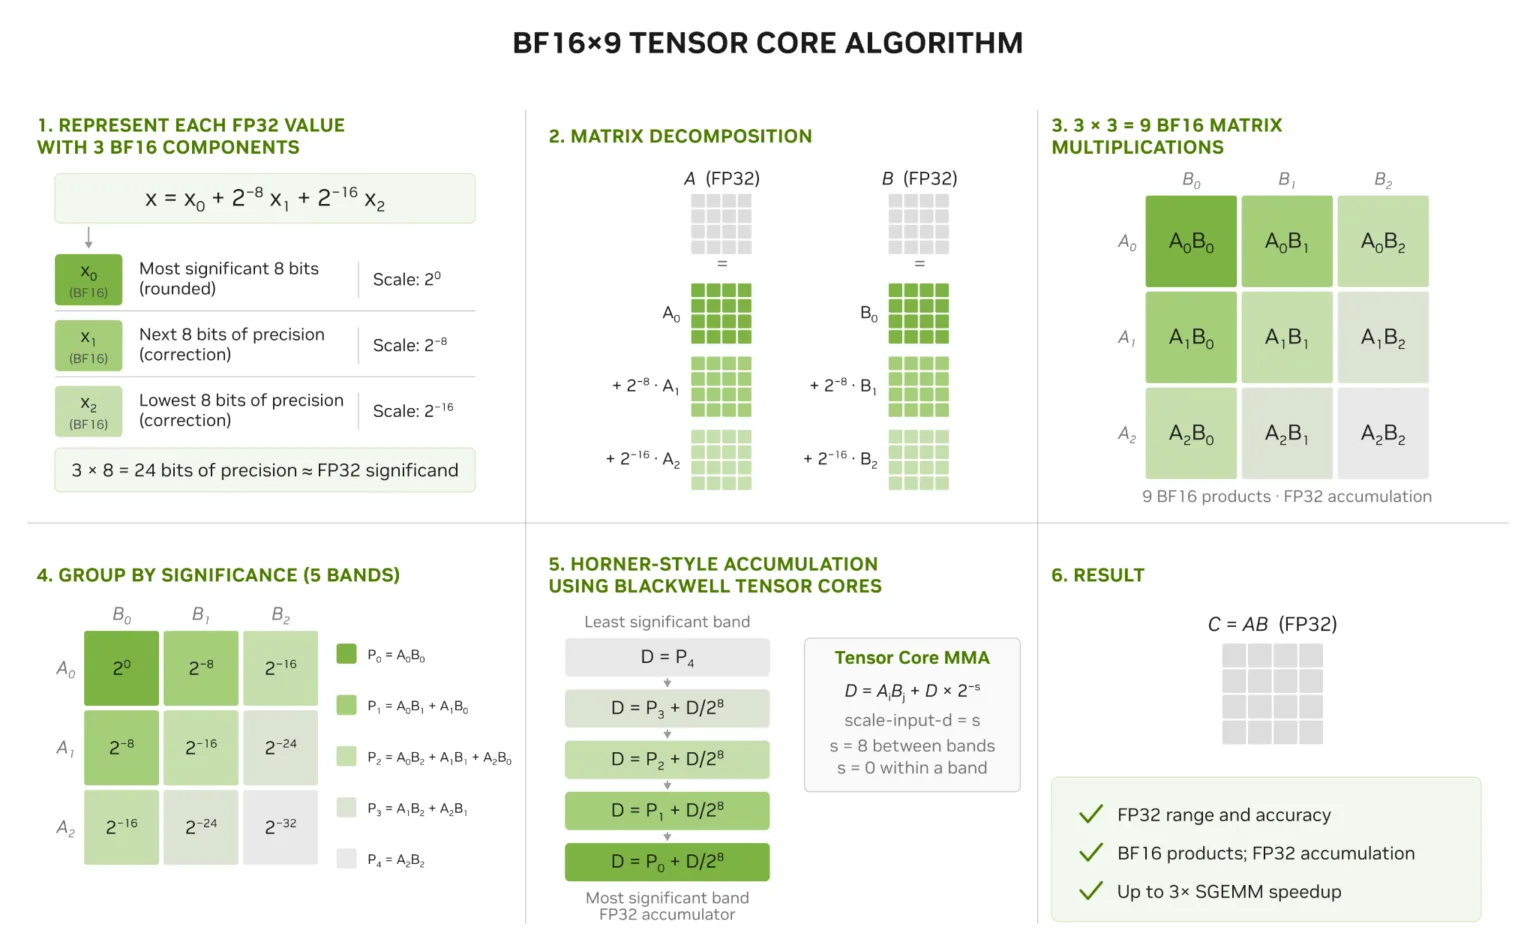
图 1. Blackwell GPU 上的 BF16x9 算法。每个 FP32 操作数被拆分为三个带缩放的 BF16 分量,生成九个成对乘积,这些乘积沿五条反对角线带以 FP32 格式累加。
在 Blackwell GPU 上,NVIDIA cuBLAS 提供了 BF16x9 Tensor Core 路径(见图 1)。每个 FP32 操作数被分解为三个 BF16 分量,九个成对乘积会按所需比例进行缩放后重新组合。通过设置环境变量 CUBLAS_EMULATE_SINGLE_PRECISION=1,cuBLAS 即可启用此路径。因此,兼容的 PyTorch GEMM 无需修改模型架构或实现自定义 GEMM 即可直接使用该功能。
由于该方法改变了 GEMM 的计算方式,若结合优化的图构建、算子融合、自定义内核以及 NVIDIA CUDA Graphs,还可能带来额外的性能提升。本次评估未测量组合增益;实际应用中需针对每项工作负载端到端地进行验证。
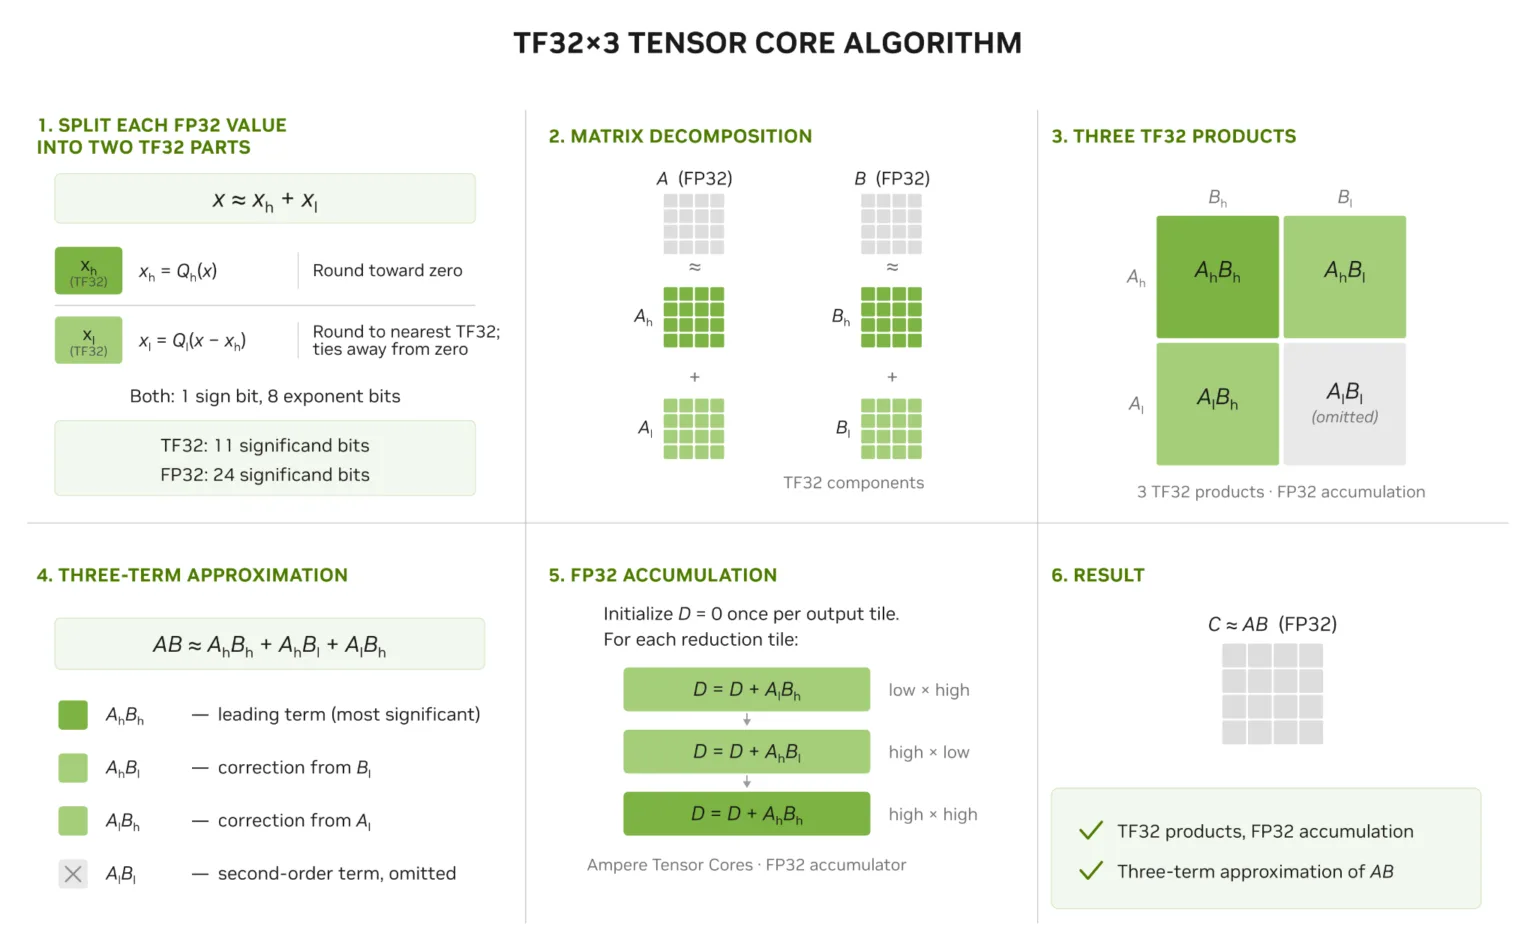
图 2. Ampere GPU 上的 TF32x3 算法。每个 FP32 操作数被拆分为一个主 TF32 分量与一个较小的残差分量。主分量与主分量、以及两个主分量与残差分量的乘积均以 FP32 累加;残差分量之间的乘积则被省略。
TF32x3 方法在 Ampere GPU 上应用了相同的原理(见图 2)。TF32x3 使用一个主 TF32 分量和一个残差 TF32 分量来表示每个 FP32 操作数。与 BF16x9 不同,我们的 TF32x3 实现不使用缩放因子。它计算三个交叉乘积并省略残差项,如下式所示:
a \cdot b \approx a_{\mathrm{hi}}b_{\mathrm{hi}} + a_{\mathrm{hi}}b_{\mathrm{lo}} + a_{\mathrm{lo}}b_{\mathrm{hi}}
NVIDIA CUTLASS 通过 OpMultiplyAddFastF32 算子提供此方案。输入与输出均保持 FP32 格式。Tensor Core 执行三个 TF32 乘积运算,并在 FP32 下完成累加。
在 PET 上基准测试 Tensor Core FP32 矩阵计算
我们在包含 192 个原子的水盒子与包含 17,280 个原子的超胞中,评估了参数量为 26M 的 PET-MAD 小型检查点(pet-mad-s-v1.6.0-nn-32)。同时,我们也在 192 原子系统中评估了参数量为 255M 的大型检查点(pet-mad-m-v1.6.0)。我们将预测的能量、力与应力结果与原生 FP32 路径的输出进行了对比。
NVIDIA Blackwell GPU 上的 BF16x9 方法
在计算能力为 10.0 或 10.3 的 NVIDIA Blackwell GPU 上,cuBLAS 支持通过环境变量、数学模式或计算类型来启用 BF16x9(分别对应请求参数 CUBLAS_COMPUTE_32F_EMULATED_16BFX9、CUBLAS_FP32_EMULATED_BF16X9_MATH 或 CUBLAS_EMULATE_SINGLE_PRECISION=1)。在使用该路径进行单精度通用矩阵乘法(SGEMM)时,无需修改模型代码。
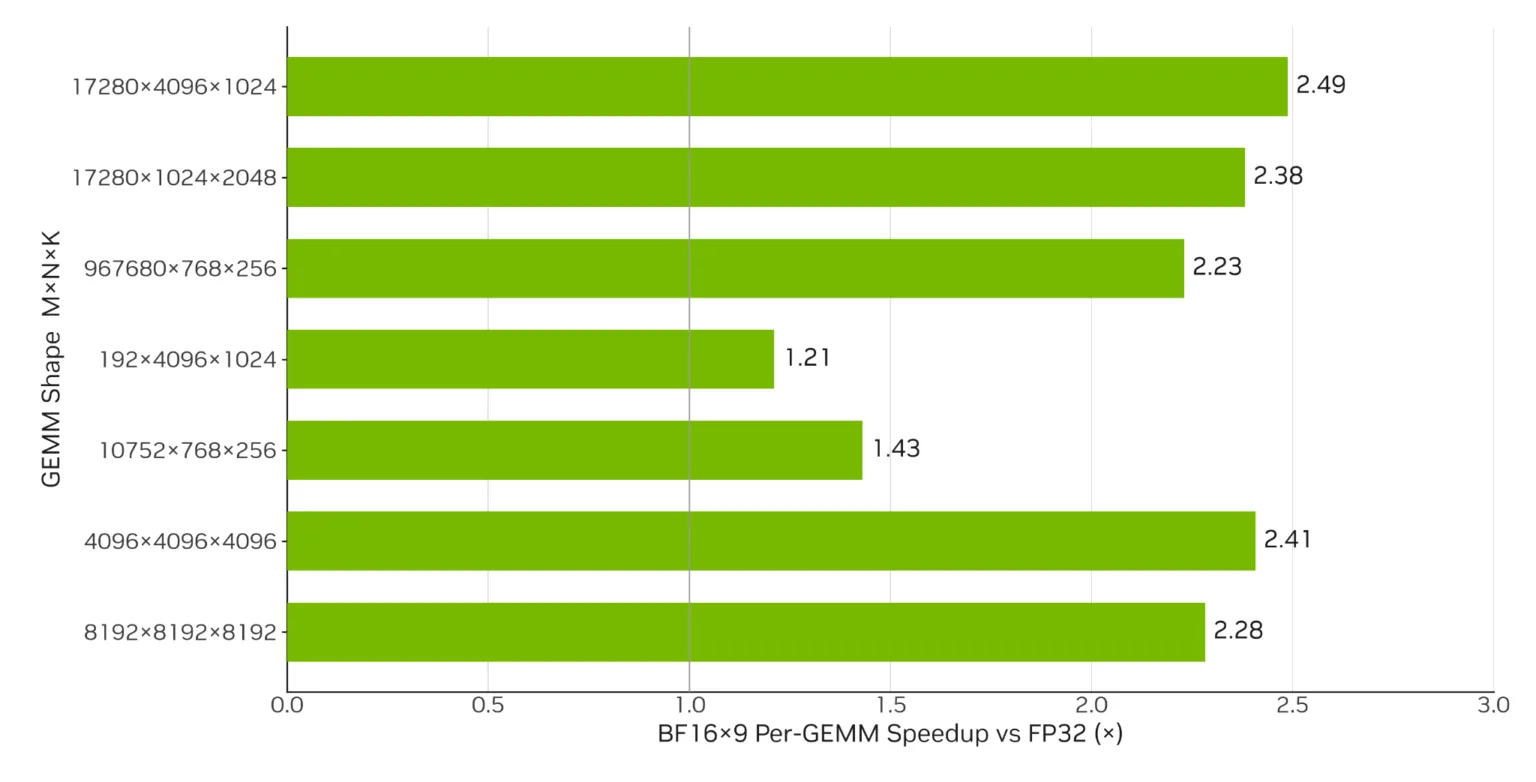
图 3。对于 SGEMM 使用 BF16x9 Tensor Core 数学运算后,PET 模型中的大型 GEMM 在 17,280 原子负载下加速了 2.2–2.5 倍,在 192 原子负载下加速了 1.2–1.4 倍。
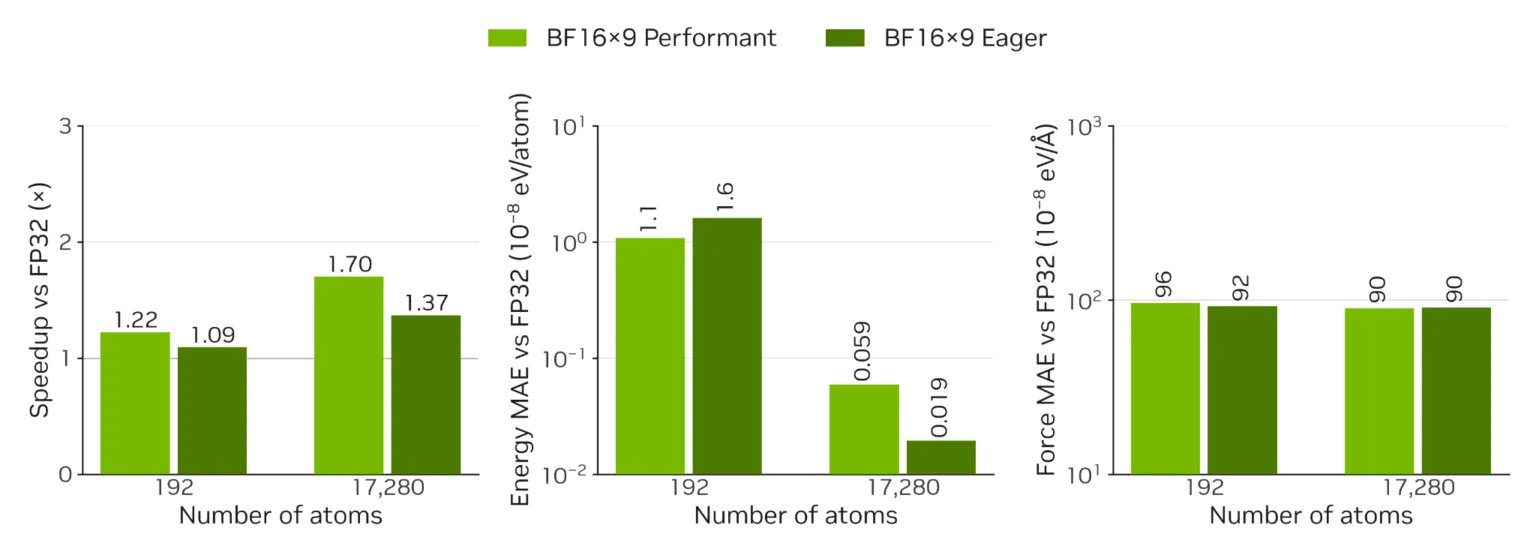
图 4。在 192 原子水盒子及其 17,280 原子超胞上,cuBLAS 的 performant 与 eager BF16x9 模式相对于编译版 FP32 的 MD 步加速比,以及单点能量与力的精度。
在 Blackwell 架构上使用 BF16x9 时,PET 中的大型 GEMM 在 17,280 原子负载下实现了 2.2–2.5 倍的加速(见图 3)。图 4 对比了 cuBLAS 的 performant 与 eager 策略相对于编译版 FP32 的 MD 步加速比,以及单点能量和力的精度。
- 192 原子系统:performant 策略使 MD 步加速了 1.2 倍,而 eager 策略达到了 1.1 倍。
- 17,280 原子系统:performant 策略实现了 1.7 倍加速,eager 策略实现了 1.4 倍加速。
performant 策略仅在 cuBLAS 预期其速度更快时使用 BF16x9;而 eager 策略则在操作支持时始终启用它。重要的是,由 BF16x9 Tensor Core 方法引入的误差低于模型自身的不确定性水平。这一结果意义重大,因为 PET 已将大部分运行时表达为优化后的 GEMM 工作,但 BF16x9 路径在不重新训练模型、不更改其 Transformer 架构、也不编写自定义内核的情况下,依然释放出了性能余量。
Ampere GPU 上的 TF32x3 方法
在 Ampere GPU 上,我们通过将 PET 的标准 nn.Linear 层替换为调用 CUTLASS C++ TF32x3 内核的自定义 TF32Linear 层来实现 TF32x3。
CUTLASS C++ 在示例 27 中提供了该方法的参考实现。PET 实现中的关键设置如下:
cutlass::arch::OpMultiplyAddFastF32
该设置选择了 CUTLASS 快速且精确的 FP32 乘法模式。内核将每个 FP32 操作数表示为高位(leading)和低位(residual)TF32 分量。Tensor Core 随后计算三个乘积——高位乘高位,以及两个高位乘低位的乘积,并在 FP32 中累加它们。最小的低位乘低位乘积被省略。CUTLASS C++ 算子声明为使用 float 类型的输入和输出。因此,PET 继续提供普通的 FP32 激活值和权重,并接收 FP32 结果;从模型其余部分的角度来看,该层的表现与标准 nn.Linear 无异。仅底层矩阵乘法的实现发生了变化。该 C++ 示例针对 sm80(Ampere)编写,也可编译用于 sm90(Hopper)。
自定义的 TF32Linear 模块会替换兼容的 PyTorch 线性层,并使用 CUTLASS C++ TF32x3 内核执行矩阵乘法,同时保留训练好的权重、偏置和输入形状。
由于 PET 通过微分预测能量来计算力,因此 TF32x3 也用于将梯度传播至层输入。这确保了能量和力的计算均使用 TF32x3 Tensor Core 算术运算。权重梯度仍走标准 PyTorch 路径,但在固定权重的推理过程中并不需要它们。
图 5. 在搭载 NVIDIA A100 Tensor Core GPU 的设备上,针对 17,280 原子负载,TF32x3 Tensor Core 数学运算使大型 PET SGEMM 相比原生 FP32 加速了 1.7–1.9 倍。
图 6. 单次传递 TF32 与 TF32x3 的 MD 步长加速比及单点精度,均以各自对应的 FP32 基线为基准进行测量。
在 A100 上测试 PET 的主要线性层形状时,TF32x3 使 GEMM 加速了约 1.7–1.9 倍(图 5)。图 6 对比了单次传递 TF32 与 TF32x3 的 MD 步长加速比及单点精度,两者均以各自的 FP32 基线为参照。单次传递 TF32 虽然获得了更高的加速比,但以牺牲更多的精度和轨迹稳定性为代价(图 6–7)。
小型检查点(2600 万参数):结果展示了包含 192 个原子的水盒子及其 17,280 原子的超胞的表现。重新编译后,TF32x3 将力误差控制在 FP32 运行差异的大约三倍以内,并在更大系统中使 MD 步长加速了 1.5 倍。
大型检查点(2.55 亿参数):在 192 原子系统中,TF32x3 实现了 1.4 倍的加速,而小型检查点仅为 1.2 倍。其力误差为 3.9 × 10⁻⁶ eV/Å,与小型检查点基本保持一致。
验证物理一致性
对于分子模拟而言,仅匹配孤立的能量和力预测只是数值保真度的初步检验。力是学习到的势能面的梯度,会在多个时间步长中进行积分,因此即使微小的数值不规则也会使势能面变得粗糙、破坏轨迹稳定性,或产生非物理的能量漂移。因此,Tensor Core FP32 方法的前景尤为诱人:它能在保持 FP32 所期望的平滑稳定行为的同时,释放矩阵乘法的 Tensor Core 性能。
我们使用两项独立测试来评估势能平滑性与能量守恒(图 7)。为测试能量平滑性,我们将单个 CO 分子从 Pt(111) 表面的顶位刚性拖离,并在 1.2 至 6.0 Å 范围内以 8.1 × 10⁻² Å 为步长,在 60 个碳原子高度下评估总能量。TF32x3 完美贴合了平滑的 FP32 CO/Pt(111) 能量曲线,而单次传递 TF32 则引入了明显的逐点波动。
在另一个包含 192 个原子的水盒子 NVE 模拟中,FP32 与 TF32x3 表现出相当且有界的能量波动,而单次传递的 TF32 则出现了更大的系统性漂移。结果表明,TF32x3 不仅在单点精度上达标,还在所测系统中保持了势能平滑性并维持了能量守恒。
图 7. 192 原子水盒子在 30 ps NVE 轨迹期间的 CO/Pt(111) 势能曲线与总能量漂移
测试结构弛豫
结构弛豫同样用于检验数值保真度,因为优化器会反复利用预测的力来更新原子几何构型。微小的力不一致可能会改变优化路径、增加所需步数,或导致系统无法达到预期的力容差。我们使用 NVIDIA ALCHEMI Toolkit 中的 PET 和 FIRE2 优化器对一块含 539 个原子的康托尔合金板进行了弛豫。在三次重复实验中,FP32 在 218 步内收敛,TF32x3 在 218 至 222 步内收敛;所有运行均达到了 1.0 × 10⁻³ eV/Å 的力容差要求。而对于单次传递的 TF32,三次实验均未能在 500 步的限制内收敛,且力的值在约 1.2 × 10⁻³ eV/Å 处趋于平稳。
TF32x3 将每个优化步骤的加速比提升至 1.5 倍,同时保持了与 FP32 相同的收敛速率与标准(图 8)。单次传递的 TF32 虽然实现了每步 2.0 倍的加速,但即使将优化步数限制翻倍至 1000 步,仍未能收敛。
这些结果凸显了 Tensor Core 路径的实际价值:在无需牺牲 FP32 工作流收敛行为的前提下,实现显著的性能加速。
图 8. 使用 NVIDIA ALCHEMI Toolkit 中的 PET 和 FIRE2 优化器弛豫的 539 原子康托尔合金板(Co₁₀₈Cr₁₀₈Fe₁₀₈Mn₁₀₇Ni₁₀₈)在三次重复实验中,FP32、TF32x3 与单次传递 TF32 的每步加速比及力收敛情况
局限性与决策标准
端到端的性能增益取决于系统规模以及 GEMM 在运行时间中所占的比例。小型系统通常受益较少,因为启动开销、邻居处理、图操作及其他非 GEMM 任务占据了运行时间的较大比例。当 GEMM 承担更多计算量时,大型系统能获得更多收益。此外,TF32x3 的性能还取决于针对模型矩阵形状与硬件进行的内核调优。
数值行为取决于所使用的 Tensor Core 策略。在矩阵乘法测试中,BF16x9 对照 FP64 参考值,其精度匹配甚至超过了原生 FP32,这支持将其作为受支持硬件上 FP32 GEMM 的无缝替换方案。TF32x3 具有略有不同的精度特征,应根据模型的精度与物理稳定性要求进行验证。
结论
Tensor Core FP32 方法在不重新训练或更改模型架构的情况下,有效提升了 PET 性能。TF32x3 在 A100 上将主要 GEMM 的加速比最高提升至 1.9 倍,并将完整的分子动力学步骤加速最高达 1.5 倍。BF16x9 在 NVIDIA B300 Tensor Core GPU 上实现了类似效果,主要 GEMM 加速比最高达 2.5 倍,完整步骤加速最高达 1.7 倍。正如 TF32x3 所验证的那样,Tensor Core 方法在测试的能量守恒与结构弛豫工作流中,保持了与 FP32 高度一致的数值行为。
这些结果表明,该方法同样适用于评估其他 MLIP 及精度敏感的科学机器学习模型,尤其是那些运行时间主要由大型 FP32 GEMM 主导的场景。这两种 Tensor Core FP32 策略均无需重新训练或进行架构重构。因此,它们均可作为独立的性能层进行评估,并在负载允许时与其他软件优化方案结合使用。
今天即可在你的模型中尝试 TF32x3 或 BF16x9 Tensor Core 方法——无需重新训练或更改架构。更多详情请参阅 cuBLAS 文档与 NVIDIA ALCHEMI Toolkit 文档。前往 UPET 仓库探索 PET 模型。
致谢
感谢 Nikita Fedik、Harun Bayraktar、Gregory Thomsen 与 Vamsi Sripathi 对本篇技术文章的贡献。