数据中心 / 云
让 Kubernetes 在第一天就为 NVIDIA Vera Rubin 做好 AI 就绪准备
2026年11月2日
为 NVIDIA Vera Rubin 等新型 GPU 硬件配置和优化 Kubernetes 是一项复杂且容易出错的工作。驱动程序、内核、运行时、网络、算子与调度器必须协同工作,且各项设置需针对硬件和负载进行调优。微小的不匹配都可能导致工作负载无法运行或限制性能。
NVIDIA AI 集群运行时(AICR)是 NVIDIA DSX AI 工厂平台的一部分,它通过将调优后的配置保存为可复用的配方、为现有部署工具生成软件包,并验证运行中的集群来简化此项工作。它将帮助 Kubernetes 环境在第 1 天就准备好迎接 NVIDIA Vera Rubin NVL72 计算托盘。
总体而言,NVIDIA DSX AI 工厂平台汇聚了多项技术,旨在帮助生态系统设计、构建和运营更高效的 AI 工厂。该平台包含专为支持多租户操作与扩展而设计的开源模块化软件组件。
在云原生技术栈中配置新型硬件架构,需要从最低层的绑定一直更新到编排层的底层管线。目前 Vera Rubin 仍处于早期阶段。
本文介绍了如果您当前运行的是 NVIDIA GB200 NVL72,升级时会发生哪些变化;以及在使用 NVIDIA GPU Operator 和带有 Vera Rubin 支持的动态资源分配(DRA)驱动进行早期硬件访问时,已完成哪些验证。文章还展示了 AICR 如何将上述组件整合为一套配置,供平台团队复现与验证。
从 GB200 NVL72 升级的变化:规划您的升级路径
如果您当前运行的是 GB200 NVL72,那么 NVIDIA Vera Rubin NVL72 是对同一款 NVIDIA MGX 机架级架构的演进,现已进入第三代。但部分面向用户的组件会发生变化。提前了解这些变化,有助于您结合后续版本发布计划,同步规划集群软件与配置的调整:
- GPU 驱动:Vera Rubin NVL72 需要新的驱动分支。该驱动已在 R615.23(主机安装的 R615.23 开源 GPU 驱动)上完成验证。早期支持目标定为 R610,官方平台支持将在 R620 中提供。AICR 的 GB200 基线版本为 R580.173.02。R615.23 是当前已测试的版本,并非官方 Vera Rubin 支持的确认最低要求。
- DOCA 与网卡驱动:Vera Rubin NVL72 将 GB200 NVL72 参考设计中的 NVIDIA ConnectX-7 网卡与 NVIDIA BlueField-3 数据处理单元(DPU)替换为 NVIDIA ConnectX-9 SuperNIC 与 NVIDIA BlueField-4 DPU。DOCA 3.3.0 是首个正式支持 ConnectX-9 的通用发布版(GA)。经验证的 Vera Rubin 系统镜像搭载的是 DOCA-OFED 3.3.0。此为测试床版本,并非强制要求或推荐配置。在此处,AICR 使用主机安装的网卡驱动与 DRANET 进行 Pod 分配。Network Operator 的兼容性仍需作为独立的认证步骤(请参阅 DOCA 3.3.0 发行说明)。
设备拓扑:Vera Rubin NVL72 计算托盘的网卡 / GPU / 直接内存访问(DMA)拓扑与 GB200 不同,因此对于远程直接内存访问(RDMA)网络和 GPUDirect Storage 等 I/O 密集型工作负载,必须检查 GPU 到网卡的亲和性以及 NUMA 放置。两款参考托盘均包含两颗 CPU 和四块 GPU,但 Vera Rubin NVL72 托盘暴露了八个 ConnectX-9 PCI 设备组(共 32 个功能),而 NVIDIA DGX GB200 NVL72 计算托盘仅配备四个 ConnectX-7 适配器。在 GB200 NVL72 和 Vera Rubin NVL72 托盘中,GPU 0 至 1 具有 CPU NUMA 亲和性 0;GPU 2 至 3 具有亲和性 1。GPU 到网卡的连接在单个插槽内为 NODE,跨插槽为 SYS。PCI 功能数量不代表物理端口数量(请参阅 GB200 参考架构)。
IMEX:与 GB200 NVL72 一样,多节点 NVIDIA NVLink 工作负载使用 IMEX。在使用 DRA 管理 IMEX 时,需停止、禁用并屏蔽主机的静态 nvidia-imex 服务,以防止所有权冲突。DRA v0.5.0 新增了一个仅限域隔离的 alpha 版主机托管选项;我们的集群使用的是 driverManaged 模式。(请参阅发行说明)
NVIDIA 多实例 GPU(MIG)配置档:Rubin GPU 引入了新的 MIG 配置档。R615.23 会在节点上通告这些配置档。AICR Vera Rubin 配方采用整块 GPU 分配,且不配置 MIG。本次验证未涵盖 Vera Rubin 上的 MIG 功能。
AICR 配方:所有这些变更项均已集成到新的 Vera Rubin 配方系列中,因此 aicr recipe 和 aicr validate 将直接反映已验证的组合,无需您逐一重新排查各项更改(详细信息见下文各节)。
Vera Rubin NVL72 验证
为全面验证 Vera Rubin NVL72 的支持情况,我们在 Vera Rubin 集群上部署了 AICR 运行时软件包。该部署基于官方 GPU Operator v26.7.0 版本与官方 DRA 驱动 v0.5.0 版本,并搭配宿主机安装的 R615 驱动。
训练与推理两种配方变体现已完成端到端的部署与合规性验证。针对训练场景,我们设置了初始性能门槛:通过 NVIDIA NVLink 网络执行跨节点 NCCL all-reduce 操作,该操作经由 IMEX ComputeDomain 运行,并以总线带宽下限作为准入条件。GPU Pod 可稳定运行,且 IMEX 通道已成功注入跨多个节点的资源申请 Pod 中。真实集群输出如下所示。
关于初期硬件状况的说明:新芯片的启用是一个循序渐进的过程。首轮验证曾一度受阻,原因是某台早期 Vera Rubin 集群存在硬件或互联网络问题——该问题与 GPU Operator 或 DRA 驱动无关,导致其中一台计算托盘未能接入 NVLink 网络。硬件重新插拔固定后,两台节点上的所有 GPU 均成功加入同一个干净的互联网络连通域中。
从初期启用到可复现的配方
验证组件仅是工作的一半。搭建一套可用的 Vera Rubin 集群涉及确定驱动模式、容器运行时对接方式、组件版本以及若干平台特定参数。AICR 将这些决策封装为带版本控制的配方(Recipe),从而确保在真实 Vera Rubin 硬件上的配置明确、可复现,且能在各集群间交叉验证。
新的 Vera Rubin 配方家族(服务:rke2;加速器:Vera Rubin NVL72 (vr200);操作系统:Ubuntu;包含训练、推理及 NVIDIA Dynamo 推理变体)以预览版形式发布。由于平台本身仍处于预发布阶段,该配方目前属于早期采用者路径,尚未具备正式版配方的生产级支持与生命周期认证。它编码了在此初始化阶段所做的各项决策:
- 主机管理驱动(Host-managed driver):Vera Rubin 系统镜像已预装 arm64 open-kernel-module 驱动,因此该配方会以
driver.enabled: false运行 GPU Operator,同时容器工具包仍由 Operator 管理。待官方构建版本发布后,配方将切换至 Operator 管理驱动模式。 - 配合 ComputeDomains 的 DRA 驱动:NVL72 互联架构启用了基于 IMEX 的 ComputeDomains,而整卡分配逻辑仍保留在设备插件中。
- 平台基线与特殊限制:这些设定仅编码一次,避免用户重复踩坑。Kubernetes >= 1.34.1 —— 1.34 是为了匹配 ComputeDomains/IMEX 使用的 GA 版
resource.k8s.io/v1DRA API,而.1补丁则是因 RKE2 CDI/NRI 工具链路径依赖 containerd 2.1(即 v1.34.1+rke2r1)。操作系统选用 Ubuntu 26.04,搭载针对 Vera 优化的 arm64 64k 页大小内核。此外还包括一些细节优化,例如调高 NFD 拓扑更新器的默认 60Mi 内存上限,否则在多 TB 级 NVL72 节点上会触发 OOM(内存溢出)导致进程终止。
该套件的首次部署目标是一个此前从未被整体验证过的平台组合——arm64 架构、Ubuntu 26.04、64k 页大小内核、RKE2 以及 Vera Rubin。整个流程从集群交接至健康运行状态仅耗时数小时。次日,第二台 Vera Rubin 集群成功复现了相同结果,而这种可重复性正是配方设计的核心目的与实际价值。
实时 Vera Rubin 集群上的工作流
为具体说明,以下展示在实际运行的 Vera Rubin NVL72 参考集群上使用 AICR v1.0.0 工具链执行的实际 AICR 工作流。
- 生成配方 配方生成为离线操作:它根据配方目录解析条件,仅需数秒即可完成。
$ aicr recipe \
 --service rke2 \
 --accelerator vr200 \
 --os ubuntu \
 --intent training \
 -o recipe.yaml

[cli] building recipe from criteria: criteria=criteria(service=rke2,
accelerator=vr200, intent=training, os=ubuntu)
[cli] recipe generation completed: output=recipe.yaml components=14
componentNames=cert-manager, dra-node-labeler, dranet, gpu-operator,
k8s-ephemeral-storage-metrics, kai-scheduler, kube-prometheus-stack, nfd,
nodewright-customizations, nodewright-operator, nvidia-dra-driver-gpu,
nvsentinel, prometheus-adapter, prometheus-operator-crds
overlays=5
解析后的配方将五个覆盖层组合为 14 个组件。除了 GPU Operator(主机管理驱动模式)和 DRA 驱动(启用 ComputeDomains)之外,它还部署了该平台最专属的两项功能:DraNet(用于将 ConnectX-9 设备分配给 Pod 的 DRA 网络驱动,ConnectX-9 上的 RDMA 数据路径性能不在本次验证范围内)以及通过 NodeWright 调优启用的独占 RDMA netns 模式。每个 Pod 仅能看到其自身的 Host Channel Adapter (HCA)。
AICR 还整合了 NVIDIA DSX AI Factory Platform 的各项组件:NodeWright 通过其原生 vr200/rke2 配置文件实施节点调优,KAI Scheduler 负责工作负载调度,NVSentinel 监控运行时健康状态。Node Feature Discovery (NFD) 与 Prometheus 栈完善了该配方,所有组件版本均锁定为在 Vera Rubin 硬件上验证通过的配置。
2. 渲染部署包
部署包是一组按顺序排列的、针对各组件的 Helm Chart,并附带一个统一的部署脚本:
$ aicr bundle -r recipe.yaml -o ./bundle
Files generated: 61

$ ls bundle
001-cert-manager 008-gpu-operator checksums.txt
002-dranet 009-k8s-ephemeral-storage-... deploy.sh
003-nfd 010-kai-scheduler README.md
004-nodewright-operator 011-nvidia-dra-driver-gpu recipe.yaml
005-nodewright-customizations 012-nvsentinel
006-prometheus-operator-crds 013-prometheus-adapter
007-kube-prometheus-stack
3. 快照与验证
AICR 会捕获集群的实际状态,将其与配方的就绪约束进行比对,随后以集群内任务的形式运行各项验证检查:
$ aicr snapshot --output snapshot.yaml
$ aicr validate -r recipe.yaml -s snapshot.yaml --phase deployment
[cli] readiness constraint passed: name=OS.release.VERSION_ID
expected=26.04 actual=26.04
[cli] readiness constraint passed: name=OS.sysctl./proc/sys/kernel/osrelease
expected=>= 7.0 actual=7.0.0-2008-nvidia-bos-64k
[cli] phase completed: phase=deployment status=passed validators=4 passed=4
$ aicr validate -r recipe.yaml -s snapshot.yaml --phase conformance
[cli] phase completed: phase=conformance status=passed validators=8 passed=8

$ aicr validate -r recipe.yaml -s snapshot.yaml --phase performance
[cli] phase completed: phase=performance status=passed validators=1 passed=1
性能阶段以集群内任务的形式运行 NVIDIA Collective Communications Library (NCCL) 的全归约门禁测试:该测试通过 IMEX ComputeDomain 在 NVLink 拓扑上执行跨节点全归约,并将结果与配方规定的总线带宽下限进行比对。rke2/vr200 组合已注册于验证器的适用性矩阵中,其运行时环境作为内置模板分发,因此验证器会自动配置 ComputeDomain 与 IMEX ResourceClaimTemplate——无需任何 Operator 前置依赖,也无需配方提供额外的运行时。该测试基于标准 v1.0.0 版本发行。
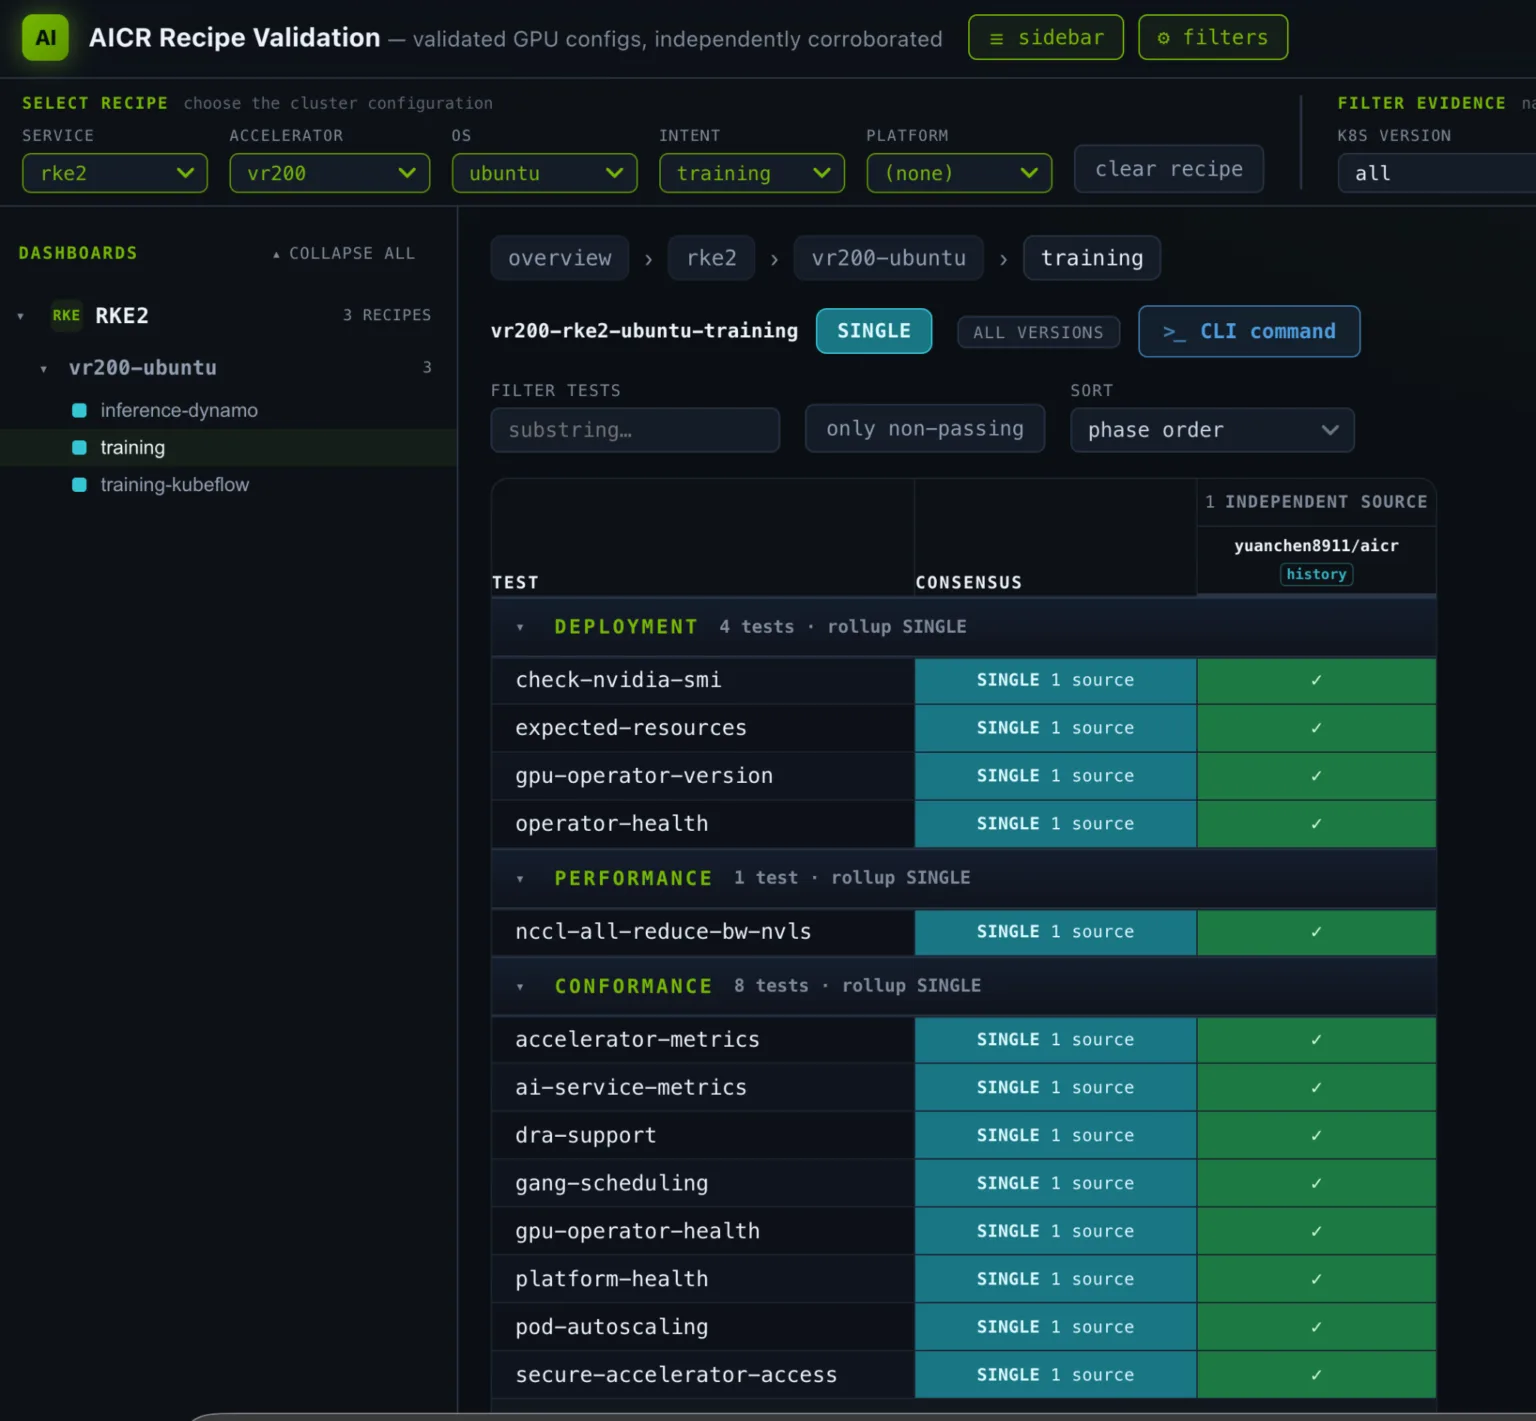
至此,完整矩阵的所有验证均已通过。
| 检查类别 | 检查项 | 结果 | 说明 |
|---|---|---|---|
| deployment | operator-health | pass | 所有组件运行正常。 |
| deployment | gpu-operator-version | pass | 版本门控要求已满足。 |
| deployment | expected-resources | pass | 所有预期的 Kubernetes 资源均已存在且运行正常。 |
| deployment | check-nvidia-smi | pass | 所有节点上的 nvidia-smi 运行正常。 |
| conformance | platform-health | pass | 所有平台检查均通过。 |
| conformance | gpu-operator-health | pass | 所有 Operator 组件运行正常。 |
| conformance | accelerator-metrics | pass | DCGM 指标路径端到端验证完成,所有 GPU 均在上报数据。 |
| conformance | ai-service-metrics | pass | Custom-metrics API 正在提供服务。 |
| conformance | dra-support | pass | 支持 DRA / ComputeDomain。 |
| conformance | gang-scheduling | pass | KAI 集群调度(Gang Scheduling)。 |
| conformance | pod-autoscaling | pass | External-metrics API 配合 HPA 扩缩容(1 → 3 扩容,3 → 1 缩容)。 |
| conformance | secure-accelerator-access | pass | Device-plugin 模式(无 gpu.nvidia.com DeviceClass)。 |
| performance | nccl-all-reduce-bw-nvls | pass | 首次跨节点 NCCL All-Reduce 性能测试:在多节点 NVLink(IMEX ComputeDomain)上跨越两个计算托盘进行,16 GiB 下总线带宽达 744.71 GB/s。 |
表 1. Vera Rubin NVL72 训练工作负载的 AICR 验证结果:所有部署、合规性及性能检查均通过,包括在 Vera Rubin 硅片上实现的首次跨节点 NCCL All-Reduce 性能门限测试。
推理变体(Dynamo 平台、推理网关、集群调度、DCGM 指标)在同一集群上同样通过了全部部署与合规性检查矩阵。
此次运行中有两项输出值得展示。首先是预发布驱动程序的 nvidia-smi 横幅信息,正是这一细微改动导致验证器在初次接触时触发报错。它很好地体现了早期硅片带来的常见小惊喜。该修复方案(NVIDIA/aicr#1748)已合并,并在 NVIDIA Vera Rubin 硬件上验证通过。
$ nvidia-smi | head -3
+--------------------------------------------------------------------+
| NVIDIA-SMI 615.23 KMD Version: 615.23 CUDA UMD Version: 13.4 |
+--------------------------------------------------------------------+
其次是实时 GPU 遥测数据通过标准的 DCGM Exporter 路径流转。请注意其中的占位符产品名称,该名称将在临近正式发布并分配 PCI ID 后自动解析为实际值:
DCGM_FI_DEV_SM_CLOCK{gpu="0",modelName="NVIDIA Graphics Device",
 DCGM_FI_DRIVER_VERSION="615.23"} 120
4. 跨节点 ComputeDomain 测试
最后是 DRA / IMEX 路径的端到端测试:这是一个双节点 ComputeDomain,每个计算托盘上的 Pod 分别占用了各自的 IMEX 通道。对于使用主机管理 IMEX 的镜像,有一个前置条件:必须禁用并屏蔽主机上的静态 nvidia-imex 服务,因为主机管理 IMEX 与 DRA 管理的 ComputeDomain 互斥(DRA 驱动程序 v0.5.0 新增了主机管理模式选项)。
GPU Operator v26.7.0+ 注意事项:该 Chart 自带一份更严格的 resource.nvidia.com_computedomains.yaml 自定义资源定义(CRD),其中 numNodes 字段无默认值(DRA 驱动 Chart 的版本则不同)。此差异仅影响全新集群安装——Helm 不会覆盖已安装的 CRD,因此现有集群升级 gpu-operator 不受影响。若部署新集群,请在 ComputeDomain 清单中显式设置 numNodes,例如 spec: {numNodes: 2, …}。
$ kubectl apply -f cd-2node-test.yaml
computedomain.resource.nvidia.com/cd-2node-test created
pod/cd-test-c01 created
pod/cd-test-c02 created

$ kubectl get computedomain,resourceclaims,pods -n cd-test
NAME STATUS NODES
cd-2node-test Ready vr-...-c01,vr-...-c02

NAME STATE AGE
cd-test-c01-imex-channel-k9j2d allocated,reserved 32s
cd-test-c02-imex-channel-l6tl2 allocated,reserved 30s

NAME READY STATUS NODE
cd-test-c01 1/1 Running vr-...-c01
cd-test-c02 1/1 Running vr-...-c02

$ kubectl logs cd-test-c01 -n cd-test # identical output on c02
crw-rw-rw- 1 root root 505, 0 channel0 # /dev/nvidia-caps-imex-channels
从执行应用到两个 Pod 运行完毕(每个计算托盘一个,各自注入 IMEX 通道并将 IMEX 守护进程加入同一域)约需 12 秒。相同的 ComputeDomain 路径正是当前训练配方在真实负载流量下驱动的 NCCL 性能检查点:上述步骤已验证通道注入,而互联带宽则在性能测试阶段得到验证。
整个流程(包括配方、软件包、快照以及部署与合规性验证阶段)在真实集群上完成约需五分钟。性能测试阶段会额外增加 NCCL 任务本身的运行时间。
验证证据与反馈循环
这些结果以 AICR 在 NVL72 参考环境中的部署、合规性与性能验证为基础,并结合了端到端 ComputeDomain 测试的成功案例。各项检查的详细信息已收录于上方的验证矩阵中。
同样重要的是当前已验证的技术边界。训练配方现已引入跨节点 NCCL 性能检查点:这是首次在 Vera Rubin 硅片上进行性能验证,在真实的 All-Reduce 流量下跑通了上述相同的 IMEX ComputeDomain 路径。
推理服务性能目前暂延后评估。vLLM 在 v0.27.0 版本中合并了对 Rubin(sm_107a)的支持,但 SM107 内核路径在编译时依赖 NVIDIA CUDA >= 13.4——而 vLLM 官方发布的镜像(截至 v0.28.0)仍基于 CUDA 13.0.3 构建。因此,即便是最新的 vLLM 发行版镜像也仅包含调度代码,并未附带编译好的内核。ai-dynamo 的最新发布版(v1.4.2)锁定的是 vllm-openai v0.26.0,该版本早于相关代码;其未发布的 main 分支锁定的是 v0.28.0,且未针对 13.4 进行构建。要在 VR200 上确立推理性能基线,需要一款公开发布、基于 CUDA >= 13.4 构建并在真实硬件上验证过的运行时镜像——不仅要通过版本检查,更要实际绕过 JIT 编译崩溃问题。
Vera Rubin 配方的签名验证证据已对外公开,涵盖训练(三个阶段,包含 NCCL 性能门禁)与推理(部署及一致性测试)。由于这些配方仍处于预览阶段且持续迭代,请将已发布的证据视为其采集时对应版本的历史记录,而非对当前配方内容的背书。若使用今日的配方进行摘要校验,将会提示不一致。
图 1。在 Vera Rubin 平台上执行的 AICR 验证会生成签名且支持公开验证的证据,并将发现的问题反馈至上游组件。
系统初始化(bring-up)同样实现了双向验证。在 Vera Rubin 上执行 AICR 验证时,发现了 go-nvlib 软件包中存在未映射的 Rubin 架构标识,该问题会导致 DRA 驱动的 kubelet 插件陷入崩溃重启循环。鉴于架构支持首先集成于 go-nvml,随后同步至 go-nvlib,并进一步下发至 GPU Operator、Kubernetes Device Plugin、MIG Manager 以及 DRA 插件,该修复方案得以在整个技术栈中保持一致地向下传递。
整个流程从首次收到崩溃报告到在 Vera Rubin 硬件上完成验证构建,仅耗时约三天。该修复(go-nvlib 0.11.0 升级至 0.12.0)已随官方 DRA 驱动 v0.5.0 版本正式推送,因此 Vera Rubin 配方直接锁定官方发行标签,无需依赖任何预发布构建。
验证过程还揭示了一个限制:当前环境下由主机管理的 IMEX 守护进程与由 DRA 管理的 ComputeDomain 无法共存于同一节点。此项反馈直接促成了 DRA 驱动 v0.5.0 中新增的主机管理 IMEX 选项。
Vera Rubin 配方已收录于开源仓库 NVIDIA/aicr 的 v1.0.0 版本中,该版本会在公共目录内注册 rke2 服务与 vr200 加速器。
快速开始
您可以借助 AICR 公共目录中的预览版配方,在 Vera Rubin 平台上快速上手 AICR。
生成经过验证的配置仅需一条命令:
aicr recipe --service rke2 --accelerator vr200 --os ubuntu --intent training
针对上文提及的 Dynamo 推理变体,可使用如下命令生成对应配方:
aicr recipe --service rke2 --accelerator vr200 --os ubuntu --intent inference --platform dynamo
您可通过 GitHub 跟踪项目进展、查阅源代码或提交 Issue: