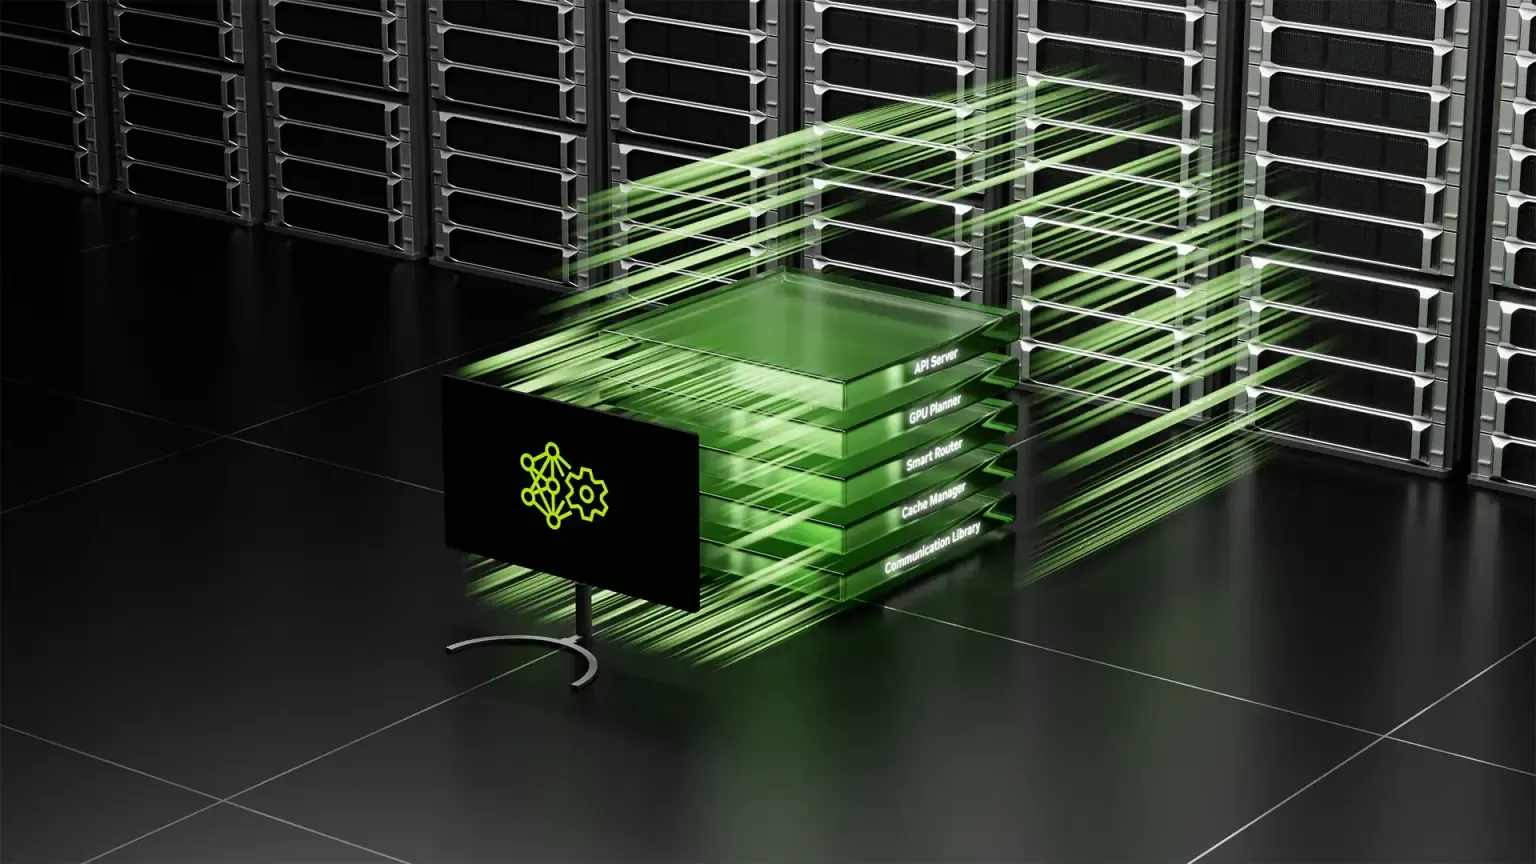
NVIDIA DSX OS 配置认证运维 Kubernetes GPU 集群
NVIDIA DSX OS 提供工具链以配置、认证和运维 Kubernetes GPU 集群。通过 AICR 建立可复现基线,NVCRE 验证集群就绪状态并识别故障节点,NVSentinel 监控健康并支持故障修复,旨在解决性能盲区,提升 AI 工厂的集群效率与韧性。
NVIDIA DSX OS 提供工具链以配置、认证和运维 Kubernetes GPU 集群。通过 AICR 建立可复现基线,NVCRE 验证集群就绪状态并识别故障节点,NVSentinel 监控健康并支持故障修复,旨在解决性能盲区,提升 AI 工厂的集群效率与韧性。
NVIDIA DSX AI Factory Platform 推出 Workload Map,为 Kubernetes 分布式 AI 工作负载提供通用结构描述。该方案消除针对不同框架的专用解析代码,使调度器、控制器和平台能直接复用定义进行巡检、同步调度及状态监控,显著提升多租户环境下的开发效率与运维一致性。
NVIDIA AI Cluster Runtime (AICR) 通过可复用配置配方,简化了 Kubernetes 对 NVIDIA Vera Rubin GPU 的驱动、内核及调度器优化。该方案确保集群在部署首日即可高效运行,解决新硬件适配复杂且易出错的问题,提升多租户 AI 工厂的运维效率。
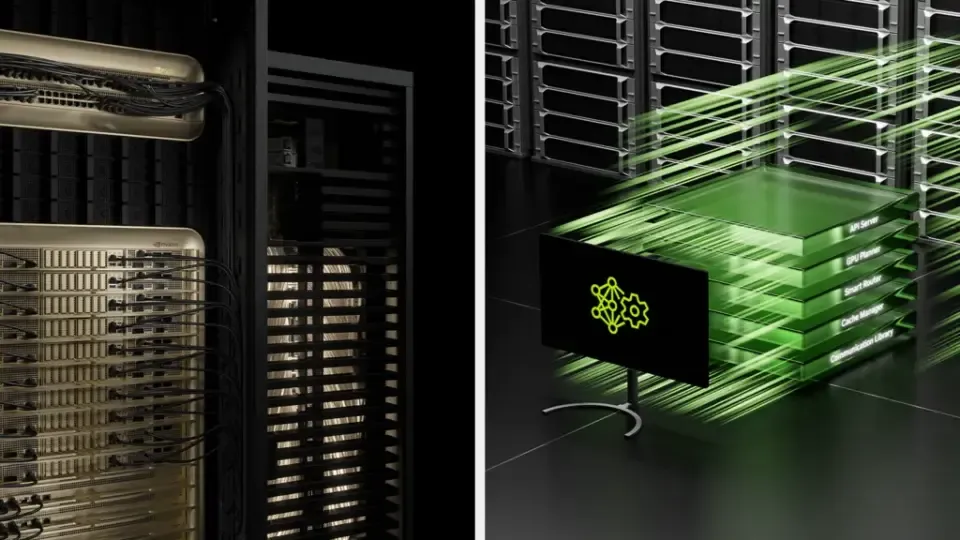
NVIDIA AI Cluster Runtime (AICR) 将 Dynamo 及其基础设施打包为经过验证的配方,解决 GPU 驱动、资源分配和调度等依赖问题。该平台提供可重复的部署路径,确保模型配置到推理端点的稳定运行,帮助团队专注于应用测试与性能优化。
NVIDIA Mission Control 2.5 将自主恢复引擎扩展至 Kubernetes 工作负载,取代传统的 Slurm HPC 限制。该功能通过自动检测、诊断和恢复异常,帮助 AI 工厂从被动运维转向自愈基础设施,显著提升大规模分布式训练集群的韧性与可用性。
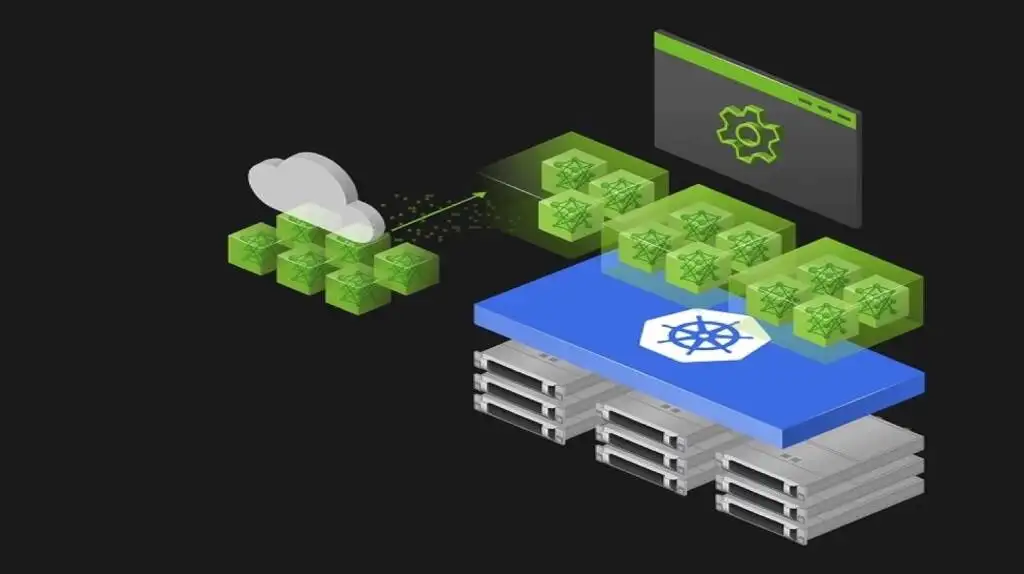
NVIDIA 发布 CUDA 13.4,新增透明内存边界强制执行功能。结合开源 GPU Fractioning Operator 与 KAI Scheduler,可在 Kubernetes 集群中为每个工作负载精确限制显存用量,解决多租户场景下 GPU 资源闲置问题,提升基础设施利用率。